每日简报 · Daily Editions
AI · 思想 · 市场 · 深度阅读

每日情报摘要

DAILY INTELLIGENCE BRIEF
本期要目In this issue

人工智能与科技

Artificial Intelligence & Technology 07
TechCrunch

黄仁勋离场后,英伟达停止向中国销售 H200

Nvidia is abandoning China after Jensen Huang's ouster

临时 CEO 科莱特·克雷斯在首次财报会上宣布,英伟达将不再向中国出货 H200,终止由黄仁勋与特朗普政府搭起的 25% 关税通道。

黄仁勋离场后,英伟达停止向中国销售 H200
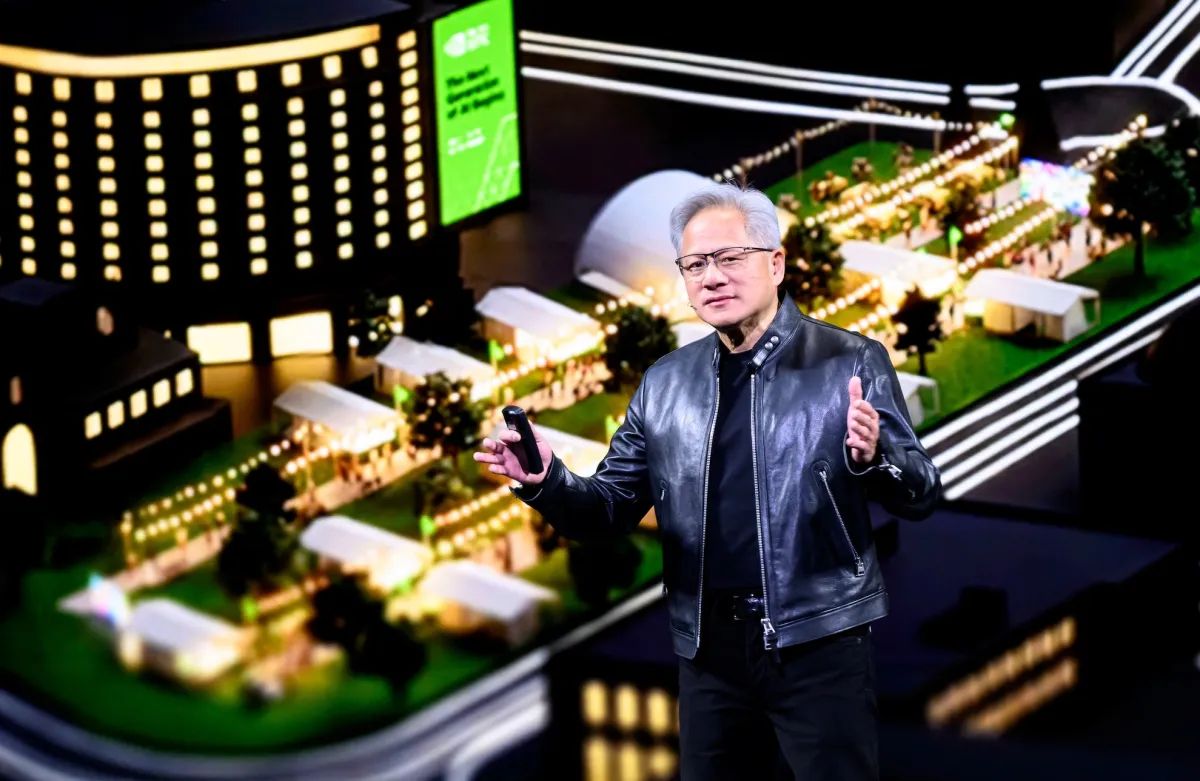
2026 年 3 月,黄仁勋在圣何塞 GTC 大会发表演讲。摄影:Josh Edelson/AFP/Getty Images
关键事实
  • H200 对华出货正式终止
  • 25% 关税通道由黄仁勋与特朗普促成
  • 杰富瑞估算 440 亿至 620 亿美元收入冲击
  • 新加坡子公司 2025 年收入 1,040 亿美元
  • 新规要求海外数据中心认证客户构成
阅读原文 · TechCrunch ↗

英伟达临时首席执行官科莱特·克雷斯在周二首次财报电话会上确认,公司将不再向中国销售 H200 芯片,结束这项由黄仁勋与特朗普政府促成的安排。该通道要求芯片经美国转运,政府从中收取 25% 关税;黄仁勋一直主张,美国技术缺席中国市场才是真正的损失。

黄仁勋上周因与一家正被调查的芯片走私公司首席执行官的关系而下台。接任后,董事会迅速设立国家安全委员会,负责出口管制合规与全球贸易风险,对华政策随之转向。克雷斯同时表示,Vera Rubin 等先进芯片的积压订单足以吸收新规冲击。

冲击并非只来自公司决定。周一生效的新规禁止先进美国芯片进入任何服务中国客户的海外数据中心。投行杰富瑞估算,这可能使英伟达明年的数据中心收入减少 440 亿至 620 亿美元。数据中心若要采购,必须认证不服务中国客户,否则可能被迫改用其他芯片。

中国此前已基本拒收 H200,倾向扶持本土芯片;但中国领先模型仍被指使用禁运的 Grace Blackwell 训练。英伟达新加坡子公司 2025 年收入曾达 1,040 亿美元,外界估计约两成收入与中国需求相关,东南亚客户也可能受影响。

Google DeepMind人工智能与科技约 2 分钟

谷歌发布 Gemini 4 Neon:百万上下文,主打“把任务做完”

Introducing Gemini 4 Neon

Neon 不追求最大参数,而是以 61 分进入 Artificial Analysis 智能指数前三,并把价格压到每百万输入 token 3 美元。

谷歌 DeepMind 发布 Gemini 4 Neon,定位不是最大模型,而是把前沿智能压进更快的端到端任务完成:软件工程、知识工作与科研流程。它在 Artificial Analysis 智能指数上以 61 分排名第三,仅次于体积更大、速度更慢的模型;在 Vals Index 上以 70.9% 排名第二,并落在帕累托前沿。

谷歌强调“可用性”:Neon 在 Agent Arena 的可操控性排名第二,能干净地接受任务中途修正;多步指令跟随与内部 Antigravity 测试中的编造率均创新低。法律研究、税务代理两个基准排名第一,Zapier 自动化基准与 Andon Labs 的 Vending-Bench 2 也排名第一,后者模拟长期经营一家企业。

价格是发布的核心信息:每百万输入 token 3 美元,缓存输入 0.15 美元,折扣 95%;输出每百万 token 15 美元;上下文窗口 100 万 token。它当天接入 Gemini API、AI Studio、企业版、Antigravity 以及 Gemini 应用,Pro 与 Ultra 订阅者可用。

这与同日的 Genie 4 一起,构成谷歌少见的一天双发:一个面向真实工作任务,一个面向可交互世界生成。对企业的含义是,模型竞争的单位从每 token 价格进一步转向每个完成任务的成本。

关键事实
  • Artificial Analysis 智能指数 61 分,排名第三
  • Vals Index 70.9%,排名第二
  • 输入每百万 token 3 美元,输出 15 美元
  • 缓存输入 0.15 美元,折扣 95%
  • 100 万 token 上下文窗口
阅读原文 · Google DeepMind ↗
谷歌发布 Gemini 4 Neon:百万上下文,主打“把任务做完”
Gemini 4 Neon 官方发布图,定位前沿智能与快速端到端任务完成。来源:Google DeepMind
Google DeepMind人工智能与科技约 1 分钟

Genie 4 开放:在世界里实时改天气、加角色、听环境声

Genie 4 is now available

Google AI Ultra 订阅者可在浏览器中生成世界,并用提示词在探索过程中直接修改环境。

DeepMind 向 Google AI Ultra 订阅者开放 Genie 4。与上一代相比,最重要的变化是“边玩边改”:用户可以在探索过程中直接输入提示词,实时改变天气、加入角色或改变动作走向,而不必退出重新生成。Genie 4 还首次加入随场景变化的自适应原生音频,从环境声到角色对白。

Genie 3 也获得升级:单次生成时长从 60 秒延长到 3 分钟,支持把多个世界串联成一段连续旅程,并可用 360 度全景图作为新世界的起点。实时世界内事件让提示词在探索中直接改变环境。

新的 Project Genie 智能体会调用谷歌多模态模型,根据自然语言描述搭建世界,并生成匹配氛围的配乐;Gemini 还能观察屏幕内容,给出下一步建议或自动触发事件。作品可发布到社区画廊,供他人探索与再混合。

这类“世界模型”仍主要面向创作与演示,距离可用的训练环境还有差距;但实时编辑、长时程一致性与音频的结合,已经把生成式视频从片段推向可停留的空间。

关键事实
  • Genie 4 向 Google AI Ultra 订阅者开放
  • 可在探索中实时用提示词修改世界
  • 首次加入自适应原生音频
  • Genie 3 单次生成从 60 秒延长到 3 分钟
  • 支持 360 度全景 grounding 与世界串联
阅读原文 · Google DeepMind ↗
Genie 4 开放:在世界里实时改天气、加角色、听环境声
Genie 4 可实时生成并编辑可交互世界,并首次加入自适应原生音频。来源:Google DeepMind
MarkTechPost人工智能与科技约 2 分钟

Anthropic 给 Claude Code 加上“代码模式”:一段 JavaScript 串起多步工具调用

Anthropic Adds Code Mode to Claude Code: Claude Now Chains Tool Calls in JavaScript

实验性功能已随 v2.1.323 发布,Claude 可并行执行命令、把结果喂给下一步,并只返回必要输出。

Anthropic 在 Claude Code v2.1.323 中加入实验性的 Code Mode,需要手动开启。此前 Claude 每一步都要单独请求 Bash、Read 或 Edit,并读取结果后再决定下一步;现在它写一段 JavaScript,在会话中一次执行多个工具调用,可以并行、把前一步输出喂给下一步,并只把必要结果返回给模型。

官方示例很典型:先用 rg 找到包含目标函数的文件,把 edit 的最大重试次数从 3 改成 5,再运行 npm test,只返回文件路径与测试输出。界面上默认看到的是工具调用与 diff,而不是代码;按 Ctrl+O 才能展开查看。

限制同样明显:只支持原生终端、Anthropic API 或 Claude 订阅,不支持 Bedrock、Google Cloud、Foundry、-p、Agent SDK、VS Code 与桌面端;Claude 等待代码最多 10 分钟,后台运行最多 2 小时。自动权限模式下的分类器审查的是整段代码,而不是每次工具调用,运行时计算出的路径等值它看不到。

Anthropic 没有公布 Code Mode 的 token 节省数字。作为参照,其 API 的 programmatic tool calling 在复杂研究任务上把平均 token 从 43,588 降到 27,297,MCP 代码执行示例则从 15 万降到 2 千;这些数字来自不同任务,不能直接横比。

关键事实
  • Claude Code v2.1.323 起实验性开放
  • 一段 JS 程序可并行多个工具调用
  • 等待代码上限 10 分钟,后台运行 2 小时
  • 不支持 Bedrock、Vertex、Agent SDK 与 IDE
  • Anthropic 未公布基准或 token 节省数字
阅读原文 · MarkTechPost ↗
OpenAI人工智能与科技约 2 分钟

OpenAI 的模型开始改芯片:Jalapeño 面积降 13%,AMD 拿到 14% PPA 提升

Advancing chip design with OpenAI models

从 GPT-4o 到 GPT-6.2 Astra,模型已能在量产级 GPU、CPU 与 RISC-V 核上提出可验证的电路改进。

OpenAI 公布 Jalapeño 推理芯片的最新结果:从 2025 年初的 GPT-4o 开始,模型就参与了电路设计。向量单元的标准单元面积减少约 13%,矩阵单元减少约 10%;其中一款乘法器在综合后少用约 15% 面积,并把延迟从两个时钟周期降到一个;另一款加法器也减少约 15% 面积而保持两周期延迟。这些改动已在芯片点亮时得到硅验证。

与 AMD 的合作更大:模型重写描述电路的 SystemVerilog RTL,在旗舰 GPU IP 上相对高度优化的基线取得最高 14% 的功耗、性能与面积改进。OpenAI 称这相当于不到 5 个月完成约一年的进度,AMD 已把部分改动送入制造,并把另一些写入未来版本的生产文件;下一代旗舰 CPU 的关键模块也验证到个位数提升。

为了衡量代际进步,OpenAI 用两个开源 32 位 RISC-V 核做评测:PicoRV32 与 OpenTitan 的 Ibex。GPT-6.2 Astra 在相同约 11.2 万 token 预算下得分最高,约为 GPT-6 Astra 的两倍;从规格书直接设计核心的得分普遍高于修改现有设计。

OpenAI 同时宣布与 Synopsys 合作训练 GPT-Synopsys,让模型像资深工程师一样使用电子设计自动化工具。风险也写在论文里:从规格出发允许模型省略性能计数器等特性,面积约束与物理综合后的时序检查仍不够接近量产标准。

关键事实
  • Jalapeño 向量单元面积减少约 13%
  • 矩阵单元面积减少约 10%
  • AMD 旗舰 GPU IP 的 PPA 提升最高 14%
  • 不到 5 个月完成约一年进度
  • GPT-6.2 Astra 在 RISC-V 评测中领先
阅读原文 · OpenAI ↗
Hugging Face / RadixArk人工智能与科技约 2 分钟

1,200 个任务、18 天:开源模型把 Terminal-Bench 通过率翻倍

DaisyRose-27B: Pushing the Frontier of Post-Training Efficiency

基于 Qwen3.8-27B 的 DaisyRose-27B 用异步强化学习把 Terminal-Bench 4.1 的 pass@1 从 5.6% 提到 12.0%,训练成本降低 57%。

RadixArk 发布 DaisyRose-27B,基于 Qwen3.8-27B,用强化学习做长时程智能体后训练。训练集只有 1,200 个精选任务,在 144 张 H200 上跑 18 天;Terminal-Bench 4.1 的 pass@1 从 5.6% 提升到 12.0%,Terminal-Bench 2.1 从 73.0 到 75.5,SWE Bench Pro v2 从 91.3 到 94.7,GPQA Diamond 从 89.2 到 90.7。模型以 Apache 2.0 开放 BF16、FP8 与 NVFP4 权重,保留 256K 上下文。

数据的关键不是数量,而是每条任务都针对原模型真实犯过的错误设计,并要求多步依赖:单次尝试最多 1.5 小时、100 次以上工具调用、25.6 万输出 token。团队与 Eigent AI 合作,从数千候选中筛出约 1,200 条,并逐条审查是否存在“没解决目标问题也能通过”的漏洞。

训练后端 Miles 采用完全异步:128 张 H200 跑智能体推理,16 张跑训练器,每一步更新后把模型发回推理集群。其模型 FLOPs 利用率达到 37%,开源 Megatron 方案在可比运行中为 16%,因此同等训练少用 57% GPU 时间;端到端约 16,800 token/秒,对比 8,300。

沙箱服务在九周内创建约 94.4 万个环境,峰值 1,566 个并发,成功率 99%,10 月下旬后超过 99.95%;云成本比通用沙箱供应商低约 80%。这套“小数据、长轨迹、高吞吐”的组合,可能比单纯扩大任务集更值得复现。

关键事实
  • Terminal-Bench 4.1 从 5.6% 升至 12.0%
  • 1,200 个任务、18 天、144 张 H200
  • MFU 37%,训练成本降低 57%
  • Apache 2.0 开放 BF16、FP8、NVFP4 权重
  • 沙箱峰值 1,566 并发,成功率 99.95%
阅读原文 · Hugging Face / RadixArk ↗
Hugging Face人工智能与科技约 2 分钟

180B 参数塞进 32GB 内存:把 MoE 专家流式加载到笔记本

180B Parameters, 32GB of RAM: Pushing MoE Inference to the Limit with Transformers

一位工程师改造 Transformers 的卸载路径,让 180B 的 Qwen3.8-Flash-Next 在 32GB MacBook 上运行,速度接近专用引擎 Strata 的 94%。

Hugging Face 工程师 Tarek Ziadé 记录了一次极限实验:在 32GB 统一内存的 MacBook 上运行 180B 参数的 Qwen3.8-Flash-Next。MoE 的专家占总权重九成以上,因此只要把“热”专家留在显存,其余放到内存甚至 SSD,小机器也有机会跑大模型。

现有引擎各有短板:llama.cpp 把专家留在 CPU 计算,专家放不进内存时页缓存会抖动;vLLM 每个 token 都重新通过 PCIe 读取专家,且没有磁盘层;Transformers 经 Accelerate 按整个模块搬运,一个 MoE 层要把整组专家拷到 GPU 却只用其中几个,实测只有 0.16 token/秒。

他的改法是把设备端最近最少使用缓存变成“槽池”:预分配一个所有层共享的设备张量,再加每层从专家 id 到槽位的映射表;把 router 选出的 id 重映射后,槽池看起来就是普通专家库,可以直接调用 grouped_mm,无需自定义矩阵乘。小模型 OLMoE 上从 10.1 提升到 34.6 token/秒,原版为 38.1。

随后他把加载器做成 from_pretrained 的 experts_offload 选项,进入 Transformers PR #50717;专家以 3 bit 量化放在磁盘,按路由流式读取。结论是:只要 SSD 而不是 Python 成为瓶颈,笔记本上的大 MoE 就可用;该实现已接近 Strata 的 token 生成速度,差距约 6%。

关键事实
  • 180B 模型在 32GB 统一内存上运行
  • 槽池复用 grouped_mm,无需自定义矩阵乘
  • OLMoE 达 34.6 token/秒,原版 38.1
  • 专家以 3 bit 量化存放在磁盘
  • 代码进入 Transformers PR #50717
阅读原文 · Hugging Face ↗

市场与地缘

Markets & Geopolitics 04
TechCrunch市场与地缘约 1 分钟

Anthropic 以每股 83 美元定价,估值 1.5 万亿美元

Anthropic reportedly prices IPO at $83 a share, above projected range

发行价高于 70 至 78 美元的区间,完全摊薄估值约 1.5 万亿美元;股票周四在纳斯达克交易,代码 ANT。

Anthropic 把 IPO 发行价定在每股 83 美元,高于最初 70 至 78 美元的区间,显示在英伟达 CEO 黄仁勋离场、AI 股动荡之际,投资者对前沿实验室的需求仍然强劲。按完全摊薄计算,公司估值约 1.5 万亿美元;5 月最后一轮私募融资时为 9,650 亿美元,数月前曾瞄准 2 万亿美元。

股票将于周四在纳斯达克开始交易,代码 ANT。招股书显示,七位联合创始人包括 CEO 达里奥·阿莫代伊,各出售近 340 万股,每人套现约 2.82 亿美元。亚马逊持股近 15%,谷歌近 14%;AMD、博通、谷歌、美光、微软、英伟达与台积电伙伴另通过私募认购 260 亿美元无投票权股份。

这次定价被视为整个 AI 一级市场的锚。OpenAI 最近估值约 1.25 万亿美元,尚未宣布 IPO 计划;Anthropic 首日表现将决定后来者能以什么折扣融资。

看空者并不缺理由:收入增速已从二季度的 token 消费热潮回落,企业开始审视 token 支出,中国开源模型也在压缩定价空间。IPO 把这些问题从私募叙事的温室,搬到了每季度披露的聚光灯下。

关键事实
  • 发行价 83 美元,高于 70 至 78 美元区间
  • 完全摊薄估值约 1.5 万亿美元
  • 亚马逊持股近 15%,谷歌近 14%
  • 战略投资者另认购 260 亿美元
  • 七位创始人各套现约 2.82 亿美元
阅读原文 · TechCrunch ↗
Anthropic 以每股 83 美元定价,估值 1.5 万亿美元
Anthropic 的 Claude 应用图标。摄影:Leon Neal/Getty Images
TechCrunch市场与地缘约 1 分钟

英伟达的初创持仓涨到 655 亿美元,黄仁勋走后投资机器面临刹车

Nvidia's startup stakes ballooned to $65B, but Huang's exit puts future deals in doubt

私募持仓九个月增长近两倍,担保总额达 1,180 亿美元;新管理层表示将“严格评估”未来的投资与承诺。

英伟达在第三财季披露,其私募股权持仓价值已达 655 亿美元,而 1 月只有 220 亿美元。增长既来自新投资,也来自既有组合公司的估值上调;仅过去一个季度就投入 160 亿美元股权,本财年前九个月累计 580 亿美元,而去年同期只有 50 亿美元。

据 PitchBook,英伟达近三年投资了近 350 家初创公司,包括 Anthropic、OpenAI、Thinking Machines、Reflection,以及 Lambda、Nscale、Crusoe 等新型云厂商。它还是数据中心建设的重要融资方:担保总额 1,180 亿美元,其中 1,050 亿美元是为 OpenAI 俄亥俄州 5,000 亿美元数据中心提供的兜底。

这些承诺由黄仁勋主导,带有强烈的个人网络色彩。马斯克称,黄与供应商的许多交易只是“与 Jensen 握手”,没有书面合同。临时 CEO 克雷斯在财报会上说,公司会继续为优质客户提供融资,但随着市场成熟、资本来源增多,将“严格评估未来的投资、承诺与担保”。

问题在于,英伟达的股权投资同时是订单的润滑剂:投给初创公司的钱,往往会变成采购 GPU 的预算。若新管理层收紧口袋,受影响的不仅是 VC 生态,也包括那些依赖英伟达背书才能融到下一轮算力支出的公司。

关键事实
  • 私募持仓 655 亿美元,1 月为 220 亿美元
  • 本季投入 160 亿美元股权
  • 九个月累计投入 580 亿美元
  • 担保总额 1,180 亿美元
  • 其中 1,050 亿美元为 OpenAI 俄亥俄项目兜底
阅读原文 · TechCrunch ↗
The Verge市场与地缘约 1 分钟

特朗普把 AI 基建搬到菲律宾:4,000 英亩“硅和平”特区引发土地争议

Trump's latest land grab is an AI hub in the Philippines

美菲计划建设 1,620 公顷园区,包含芯片厂、关键矿物加工与数据中心;原住民称被要求 12 月前搬迁。

特朗普抵达马尼拉,推动“硅和平”(Pax Silica)计划下的美菲经济安全区。拟议园区位于菲律宾,占地 1,620 公顷、约 4,000 英亩,规划芯片工厂、关键矿物加工厂与数据中心;至少二十多个国家已签署该倡议,目标是让美国摆脱对中国半导体制造与关键矿物加工的依赖。

美国国内反对数据中心与晶圆厂的声音日增,项目因此转向较不富裕的国家。菲律宾基地转换与发展署希望借矿物加工与芯片制造带动经济,官方称可能只配套一两个数据中心;两国预计在年底前签署框架协议,但细节仍被保密协议遮住。

争议集中在土地。人权观察称,项目将迫使数百名原住民与农户搬迁;阿埃塔·洪盖部落首领佩特罗尼拉·卡皮斯-穆尼奥斯说,官方要求居民在 12 月前搬走,“我们怎么放弃墓地、教堂和生计?这里是我们的水源和耕地。”

对华盛顿,这是把 AI 供应链“友岸化”的又一块拼图;对马尼拉,这是投资与主权的交换;对当地社区,这是最古老的土地问题在新一轮技术繁荣中重演。特朗普随后将赴深圳,与习近平、普京举行首次中美俄三方峰会。

关键事实
  • 园区占地 1,620 公顷、约 4,000 英亩
  • 规划芯片厂、关键矿物加工与数据中心
  • 至少二十多国加入 Pax Silica
  • 美菲预计年底前签署框架协议
  • 原住民称被要求 12 月前搬迁
阅读原文 · The Verge ↗
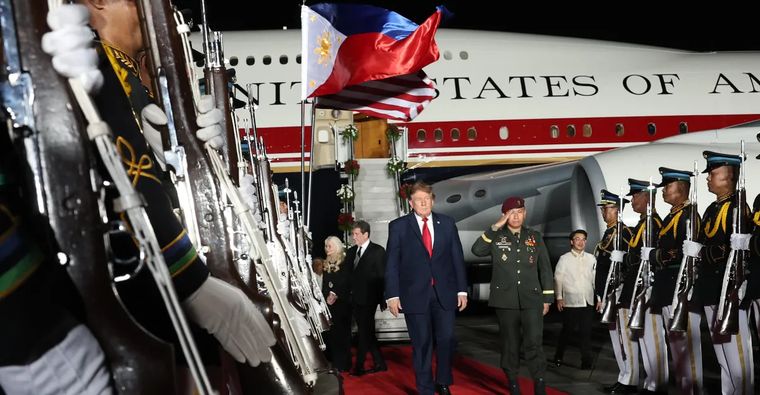
特朗普把 AI 基建搬到菲律宾:4,000 英亩“硅和平”特区引发土地争议
2026 年 11 月 17 日,特朗普抵达马尼拉维拉莫尔空军基地。摄影:Getty Images
War on the Rocks分析市场与地缘约 1 分钟

深圳首次中美俄峰会:核军控的象征意义大于实质

The U.S.-Chinese-Russian Summit and the Future of Trilateral Nuclear Talks

北京看重的是被当作平等对手的象征;真正的成果可能只是把核对话制度化,而非削减弹头。

首次中美俄领导人峰会将在深圳举行,核军控可能被列入议程。对北京而言,峰会最重要的不是能否签成协议,而是象征意义:华盛顿终于在全球治理议题上,把两个地缘与意识形态对手当作平等方对待。中国战略界普遍认为,自身快速增长的军力与核力量迫使美国承认现实。

普京倚重习近平,借峰会展示俄罗斯重返全球事务中心;北京则把自己塑造成能把两个深陷战争的对手拉到一起的关键力量。特朗普自第一任期起就想推动三边核军控,但习近平与普京都是硬现实主义者,把核武器视为历史与正义愿景的保障。

实质突破的可能性很低。中国 2026 年发布的第十五个五年计划重申“加强并壮大”战略威慑,继续扩建裂变材料生产、弹头研发与试验基础设施;北京长期拒绝三边框架,主张美俄承担主要裁军责任,也不愿接受中国应与美俄承担同等责任的暗示。

更现实的目标是制度化:让三国承诺定期、可核查的核对话,使其不再因台湾军售等无关争端被暂停,也不被当作其他议题的筹码。任何“战略稳定”表述都必须安抚无核国家,否则稳定-不稳定悖论会让低烈度冲突更易发生。

关键事实
  • 首次中美俄领导人峰会将在深圳举行
  • 中国十五五计划重申“加强并壮大”战略威慑
  • 北京拒绝三边框架,主张美俄先行
  • 实质军控突破可能性极低
  • 制度化定期对话是更现实的目标
阅读原文 · War on the Rocks ↗
深圳首次中美俄峰会:核军控的象征意义大于实质
War on the Rocks 配图,文章讨论中美俄三边核军控的前景。来源:War on the Rocks

思想与评论

Ideas & Commentary 03
Marcus on AI分析思想与评论约 1 分钟

加里·马库斯:Anthropic 的 IPO 可能是对投资者和社会都不划算的赌注

Is Anthropic's IPO a bad bet, both for investors and society?

他质疑收入指数增长的假设,认为二季度后增速已回落;并呼吁读者从人类利益出发不要认购。

加里·马库斯对 Anthropic 的 IPO 提出两点质疑。先看牛市论点:Anthropic 的模型即便不是最强,也稳居第一梯队,收入会继续指数增长。马库斯称之为“万亿磅婴儿”谬误——少数指数不会永远持续;他引用的数据显示,Anthropic 在二季度之后已经掉出收入火箭的节奏。

他认为原因不神秘:二季度是 token 消费狂欢的顶点,随后中国模型追上来,用户开始有替代选项,也更仔细地审视 token 支出,收入曲线因此走平。至于达里奥·阿莫代伊关于医学突破的承诺,他直言“荒谬”,“更可能被流星砸中”。

文章后半部分转向道德论证:即便作为投资,Anthropic 的估值也把太多未经验证的指数增长计入价格;而作为一个人工智能风险的长期警告者,他呼吁读者从人类利益出发不要认购。

马库斯并非专业投资者,但他此前的记录不差:Oracle 股价超过 300 美元时他称之为“泡沫顶部”,如今约 115 美元。对 IPO 定价而言,真正的考验不是首日涨幅,而是收入增速能否重新加速。

关键事实
  • 质疑收入指数增长的持续性
  • 称二季度后增速已经放缓
  • 认为中国模型压缩了定价空间
  • 曾将 300 美元的 Oracle 称为泡沫顶部
  • 呼吁从人类利益角度不要认购
阅读原文 · Marcus on AI ↗
FT Alphaville分析思想与评论约 1 分钟

崩盘什么时候来?问记者:170 年里警告从未缺席

When's the crash? Ask a journalist

一项覆盖 170 年媒体泡沫报道的研究发现,财经文章隐含的六个月崩盘概率平均约 20%,是历史实际频率的四倍。

伦敦商学院马尔科·格罗特里亚与剑桥大学阿丰索·蒙泰罗、康斯坦丁·扬内利斯系统梳理了 170 年的媒体泡沫叙事。他们发现,财经文章隐含的“六个月内出现重大市场崩盘”平均概率约为 20%,是历史实际频率的四倍;而这个隐含概率从未低于 12%。

更极端的是频率:在 170 年里的每一个月,都有文章警告泡沫。中位月份中,36% 的市场相关文章表达对高估的担忧,24% 提到监管或政策警告,担忧高估的比例从未低于 13%。

这并不意味着警告永远错误。研究的方法是把媒体文本转成隐含概率,再与事后实现的回撤比较;结论是财经记者集体而言是“永远焦虑的钟”,偶尔报时准确,但作为择时信号几乎没有信息量。

对当下的 AI 交易,实用结论不是忽略所有警告,而是把媒体情绪当成反向的温度计:当所有人都已经在谈崩盘时,崩盘本身可能已经被部分定价;真正的风险,往往来自没人写进标题的角落。

关键事实
  • 样本覆盖 170 年媒体泡沫报道
  • 隐含六个月崩盘概率平均约 20%
  • 历史实际频率约为其四分之一
  • 170 年里每个月都有泡沫警告
  • 中位月份 36% 文章担忧高估
阅读原文 · FT Alphaville ↗
The Verge分析思想与评论约 1 分钟

纳德拉自称“AGI 信仰者”:真正的问题是政治经济学,不是排行榜

Satya Nadella says he's AGI-pilled now

微软 CEO 警告单一模型垄断会摧毁政治经济:如果只剩资本、没有劳动,民主国家甚至无法完成选举。

在 Ignite 大会后的圆桌讨论中,微软 CEO 萨提亚·纳德拉说自己“在经济层面是 AGI 信仰者”。他关心的不是模型能否通过某项考试,而是政治经济如何围绕 AGI 重新组织:如果智能产生网络效应,企业是什么?如果全部人力资本坍缩成 token 资本,劳动者又在哪里?

他明确不认为 Claude 之类的模型有意识,并支持微软 AI 负责人穆斯塔法·苏莱曼的立场:不应给模型道德地位,也不应像 Anthropic 那样把模型当作可能有道德身份的对象。他说这不是教条,真正重要的是让经济广泛扩散这项技术。

纳德拉最尖锐的警告针对垄断:“如果马克思主义观点只剩一家公司,那对我们所有人来说都完了。”在他看来,模型没有边界,可以是医疗公司、金融公司,也可以接管政府;把它当成科技公司之间争夺下一个万亿美元市值的竞赛,是最狭窄的看法。

微软的对策因此不是押注单一模型,而是让企业按任务选择成本最优的模型、运行自有模型、控制数据主权。纳德拉承认,如果只有资本没有劳动,民主国家甚至无法赢得选举——“那不是一个经济”。

关键事实
  • 称自己在经济层面是 AGI 信仰者
  • 不认为 Claude 之类模型有意识
  • 警告单一模型垄断会摧毁政治经济
  • 提出人力资本坍缩为 token 资本
  • 微软策略是多模型与企业数据主权
阅读原文 · The Verge ↗
编辑要点
Bottom line

黄仁勋离场后的第一天,英伟达同时收缩中国业务与投资机器,AI 资本秩序从个人网络转向制度约束;Anthropic 却以 1.5 万亿美元估值把 IPO 定在区间之上,说明公开市场仍愿为少数前沿实验室买单。另一边,谷歌一天发布 Gemini 4 Neon 与 Genie 4,OpenAI 用模型改芯片,开源社区把 27B 级后训练压到 1,200 个任务、18 天——竞争正从更大的模型转向每个完成任务更低的成本。