Thinking Machines 发布 Inkling 2 Mini:26B 循环 MoE,20GB 权重跑在 32GB Mac 上
Meet Thinking Machines Inkling 2 Mini: 26B Looped MoE Runs on a 32GB Mac
26.4B 总参数、3.4B 激活的开放权重模型,靠重复中间层把检查点压到约 20GB,可在单台 32GB Mac 或 DGX Spark 上运行。
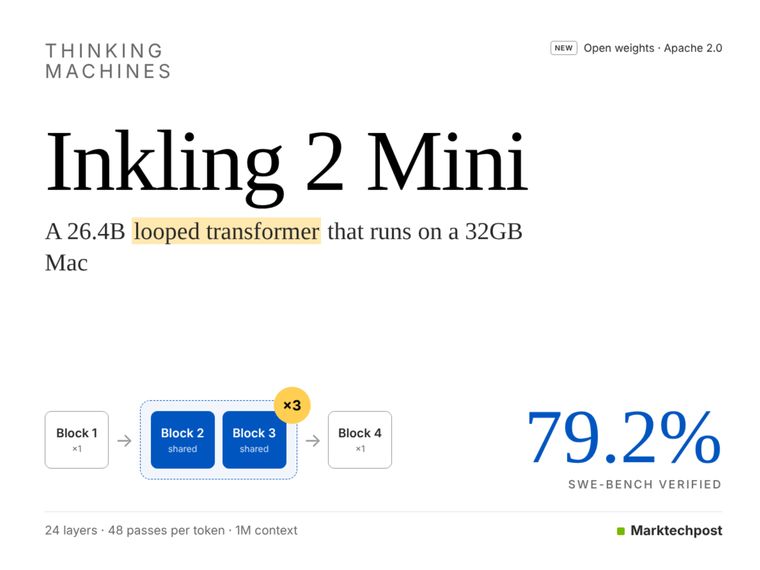
Thinking Machines Lab 发布 Inkling 2 Mini:26.4B 总参数、3.4B 激活的稀疏 MoE,Apache 2.0,权重约 20GB,可在 32GB Mac、单台 DGX Spark 或 32GB 显存 GPU 上本地运行,支持最高 100 万 token 上下文。
核心是循环 Transformer:模型只存 24 层,分 4 组,中间两组各重复 3 次、共享权重,使每个 token 实际经过 48 层计算。每次重复通过 Attention Residuals 与学习门控接收上一轮的信息;前馈层 128 个专家,每 token 路由 8 个。团队称中段循环带来 1.51 至 1.91 倍的计算等效增益,在 28 项评测中赢下 27 项;不循环的基线训练省 7.5% 算力,但要在 512k token 的 agentic 轨迹上追平损失,推理算力需多 140%。
训练先用 384 个专家,中期剪掉三分之二、保留最常用的 128 个,再用 1T token 从更大内部模型蒸馏修复,随后 SFT 与 2.2T token、2000 步的 RL。专家层以 NVFP4 训练和部署,最后 4 层用 MXFP8,官方称可消除量化转换损失。
自报成绩:SWE-bench Verified 79.2%(仅 bash)、SWE-bench Pro v2 Hard 77.9%、DeepSWE 48.2%、BrowseComp 79.0%、GPQA Diamond 86.6%、ARC-AGI-2 49.3%,AA Index 20.1 与 Qwen3.8-27B 持平。短板在知识记忆与多轮约束:HLE-Diamond 15.2%、MultiChallenge 50.0%、AA-Omniscience 为 -8.6。DGX Spark 上 Intelligence per Watt 为 0.703。
- 26.4B 总参 / 3.4B 激活,约 20GB 权重
- 24 层存重、中间两组各跑 3 次
- SWE-bench Verified 79.2%,AA Index 20.1
- Apache 2.0,32GB Mac 或单台 DGX Spark 可跑
- 弱项:HLE-Diamond 15.2%、MultiChallenge 50.0%