每日简报 · Daily Editions
AI · 思想 · 市场 · 深度阅读

每日情报摘要

DAILY INTELLIGENCE DIGEST
本期要目In this issue

人工智能与科技

AI & Technology 05
OpenAI

把标准模型放上格点:GPT-6 Astra 参与补上五十年的缺口

A step toward defining the Standard Model on a lattice

加州大学圣塔芭芭拉分校理论物理学家 Nathaniel Craig 与 GPT-6 Astra 合作,在 arXiv 提交了一个候选构造:用 overlap 费米子和逐层细化的相位规则,给完整标准模型一个非微扰的格点定义。

把标准模型放上格点:GPT-6 Astra 参与补上五十年的缺口
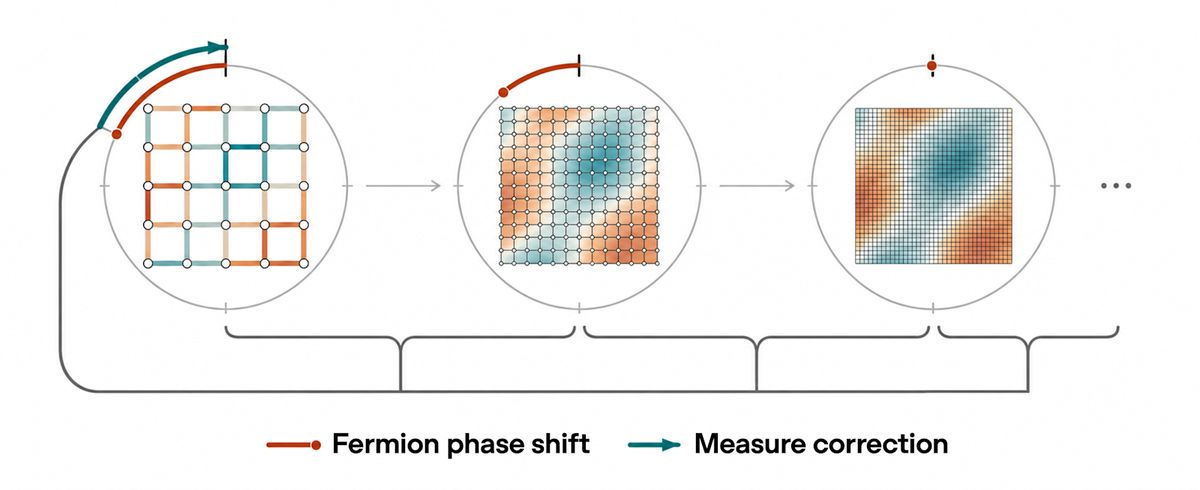
格点上的相位修正:橙色弧线表示左手费米子沿闭合路径积累的相位,青色箭头表示用相邻更细网格的差分把它抵消,使费米子测度回到出发时的相位。图片来源:Nathaniel Craig / GPT-6 Astra / OpenAI
关键事实
  • arXiv:2610.09093,2026 年 10 月预印本
  • 完整标准模型的非微扰格点定义悬置逾五十年
  • 关键工具:overlap 费米子加逐层细化的相位规则
  • GPT-6 Astra 主导证明,三位格点场论专家审读
  • 反射正定性与实际模拟仍未解决
阅读原文 · OpenAI ↗

标准模型在微扰论里精确得惊人,电子磁矩可以算到万亿分之几;但完整理论从未有过非微扰定义。把时空离散成格点是目前唯一已知的严格路径,强相互作用已经借此从第一性原理算出质子质量。障碍在于标准模型是手征理论:弱力区别对待左右手费米子,而最自然的格点规则会自动制造出不需要的“倍增子”,给左手粒子配上右手伙伴。

此前已有三段铺垫:Ginsparg 与 Wilson 在 1982 年给出格点上的手征对称残余;Narayanan 与 Neuberger 在 1994 年构造 overlap 费米子,相当于只反射左手光的“手征镜”;Lüscher 在 1999 年给出阿贝尔手征规范理论的相位处方。但从阿贝尔情形推广到完整标准模型卡了二十五年以上,因为相位依赖每个格点上规范场的具体位形。

Craig 的思路是把目标格点上的规范场表示到一串更细的格点上,比较相邻两层允许的费米子态,得到小步变化的相位修正,再沿闭合路径求和,证明它对每个允许的环路都给出正确结果,且修正主要由附近场决定、与场的数学描述无关。这把有限格距下的费米子测度定了下来,前提是场强有界。

GPT-6 Astra 不只是润色:它提出把给定规范场搬到细网格的具体方式,证明细网格比较会收敛到确定答案,并主导了详细证明。Golterman、Kronfeld、Shamir 等格点场论专家审读并提问。Craig 明确说这只是“原则上的答案”:反射正定性尚未验证,离真实格点模拟还很远;连续极限则要用到 OpenAI 此前关于 Yang-Mills 存在性的证明。

OpenAI人工智能与科技约 2 分钟

OpenAI 开科学博客:把“AI 做出来的证明”摆上台面

Our new blog for science

新博客面向科学家,讲发现、方法与局限;开篇回顾了 Navier–Stokes、准黎曼猜想、波聚焦与量子场论数学基础等结果,也承认这些工具正在改变“谁来做检查、谁来署名”。

OpenAI 上线科学博客,定位不是产品发布,而是让科学家和学术研究者讲自己用 AI 做了什么、怎么做、哪里会出错。栏目分三类:研究与发现、方法与实操指南、科学界视角;特别提到会说明如何核查结果,以及方法在什么条件下失效。

开篇列出的成绩单相当密集:9 月,一个内部系统给出了针对 Navier–Stokes 存在性与光滑性问题的证明;10 月初公布一批数学结果,其中包括对准黎曼猜想的改进,收紧给定数值以下素数个数的估计;10 月下旬又公布数学、计算机科学与物理结果,涉及波如何聚焦、高效计算的极限,以及交织量子场论的数学基础。

生物学部分更像工程:与 PerturbAI 和 Scripps Research 合作,数千个由 GPT-Rosalind 驱动的智能体在 32 分钟内分析了数百万个小鼠脑细胞的既有实验数据,把基因扰动效应与文献连接起来,提出可供实验验证的机制假说;César de la Fuente 的团队则用 ChatGPT 和 Codex 搭算法筛选抗生素候选分子,再进实验室合成测试。

博客同时抛出问题:能生成证明的系统,会改变证明如何被检查、解释和纳入学科;能穷举假说的系统,会让“选哪个实验做”变得更难而不是更容易。OpenAI 说这些问题的答案因学科而异,应由科学共同体参与塑造工具的使用方式。

关键事实
  • 三类内容:研究结果、方法指南、科学界视角
  • 9 月内部系统给出 Navier–Stokes 问题的证明
  • 10 月数学结果含准黎曼猜想与素数计数估计改进
  • GPT-Rosalind 智能体 32 分钟分析数百万小鼠脑细胞
  • OpenAI 明确表示会写方法的失败边界
阅读原文 · OpenAI ↗
Sebastian Raschka人工智能与科技约 2 分钟

RoPE 不再是默认项:2026 年开源模型的位置编码正在分叉

Understanding Positional Embeddings in Modern LLMs

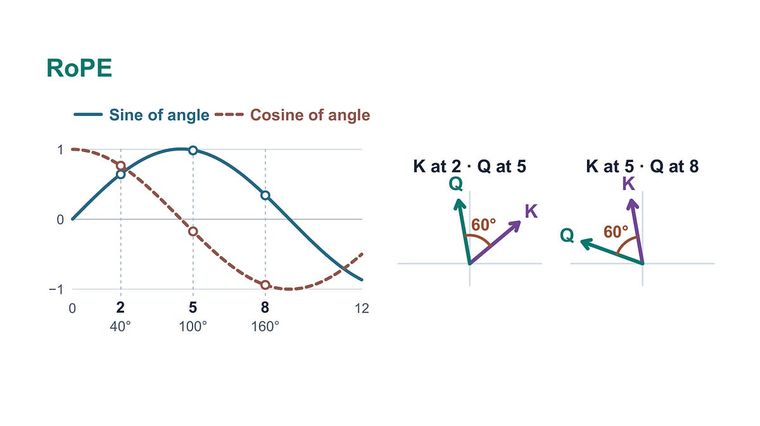
Raschka 从 GPT-2 的绝对位置向量讲到 RoPE,再统计自己维护的 LLM 架构库:全层全维 RoPE 仍是主流,但占比从 2025 到 2026 持续下降,部分 RoPE 反而成了使用 RoPE 的模型里的多数。

没有位置编码时,自注意力对 token 顺序是置换不变的:“红狐狸跳过灰狐狸”和调换两个形容词会得到相同的注意力分数。GPT-2 的做法是给每个 token 加一个可学习的绝对位置向量;现代模型更常用 RoPE,在每一层对 query 和 key 的特征对做与位置相关的旋转,使点积只依赖相对位移。

RoPE 的变体正在扩散。部分 RoPE 只旋转每个头的一部分维度:MiniMax-M3 在 128 维头里旋转 64 维,预计算的正弦余弦表因此减半,在 100 万 token 上下文、BF16 下省下约 128 MiB。arXiv 上《Fractional Rotation, Full Potential?》在 1B 到 8B 模型上发现,只旋转约 10% 的特征,训练损失和基准准确率常常接近全量 RoPE;Raschka 的判断是,省这点内存“几乎不值得”。

另一条路是 NoPE:干脆不加显式位置编码,靠因果掩码提供顺序信息。若所有可见 key 得到相同注意力权重,某个特征在位置 t 的输出会正比于 1/t,后续层可以把它当位置信号。NoPE 论文里 107M 参数的小模型在十个任务的长度外推上排第一;但 1.3B 的代码模型在最长上下文上下一 token 预测变差。SmolLM3 采用折中:36 层里每四层跳过 RoPE 一次,作者称这改善了长上下文。

Raschka 用架构库做的统计显示:在每个 softmax 注意力层都用 RoPE 仍是最常见选择,但份额在 2025、2026 以及 2026 下半年逐段下滑;在使用 RoPE 的模型里,部分 RoPE 从 2025 的少数变成 2026 两组的多数。纯 NoPE 的条目全部是带 softmax 注意力的循环混合模型;另有 Inkling 这类在注意力分数上加可学习相对位置偏置的做法,祖上是 T5。

关键事实
  • RoPE 旋转 query/key 特征对,使点积依赖相对位置
  • MiniMax-M3:128 维头只旋转 64 维,省 128 MiB 表
  • 约 10% 特征旋转在 1B–8B 上常接近全量 RoPE
  • SmolLM3 在 36 层中每四层跳过一次 RoPE
  • 全层 RoPE 仍最常见,但 2025→2026 份额下降
阅读原文 · Sebastian Raschka ↗
RoPE 不再是默认项:2026 年开源模型的位置编码正在分叉
Raschka 把 2026 年开源模型的架构按位置编码方式分组:全层全维 RoPE 仍是多数,但部分 RoPE 与跳过 RoPE 的混合方案在增加。图片来源:Sebastian Raschka / Ahead of AI
Towards Data Science人工智能与科技约 2 分钟

参数多不等于模型复杂:用 Fisher 矩阵量出量子模型的有效维度

Computing Effective Dimension for Quantum ML Models in PyTorch

TDS 的第二篇实操:有效维度问的是“数据到底能分辨多少个参数方向”,答案藏在 Fisher 信息矩阵的谱里;文章给出用 autograd 估计 FIM、再用参数采样算积分的方法。

有效维度来自统计复杂度研究,后来被用来衡量经典与量子模型的容量、表达力,乃至可训练性。它回答的问题很直接:参数空间里有多少个方向是数据真正能区分的?参数计数会把一个大部分方向都平坦的模型误判为很复杂,而有效维度看的是 Fisher 信息矩阵的特征值分布。

对参数化量子电路,模拟器给出状态 ψ(x,θ),测量结果 y 的概率是 p(y|x;θ)=|<y|ψ(x,θ)>|²。文章用 PyTorch 的 autograd 对每个不可忽略的结果求 ∂p/∂θ,再按 F(i,j)=E[∂log p/∂θ_i · ∂log p/∂θ_j] 组装 Fisher 矩阵。利用 ∂log p=(1/p)∂p,按概率 p 加权后分母 p² 正好约掉,实现上只需把梯度外积除以 p 再累加。

真实模型没有闭式期望,于是用一批数据做经验平均;概率接近零的结果会带来数值问题,代码里用 min_probability 阈值跳过。第二个难点是对参数空间积分:文章改用参数采样,在 θ 空间做蒙特卡洛,把 Fisher 矩阵的谱与采样权重合起来得到有效维度。

这套做法的价值在于诊断:如果有效维度远小于参数数,增加参数只是在扩大平坦方向;如果有效维度接近参数数,模型可能对扰动过于敏感、训练更不稳定。对量子模型,这正好连接了表达力与贫瘠高原这两个常被分开讨论的问题。

关键事实
  • 有效维度:数据可分辨的参数方向数,而非参数总数
  • 核心对象是 Fisher 信息矩阵的特征值谱
  • 用 autograd 对测量概率求梯度,按 p 加权组装 FIM
  • min_probability 阈值避免除零与数值爆炸
  • 参数空间积分用蒙特卡洛采样近似
阅读原文 · Towards Data Science ↗
参数多不等于模型复杂:用 Fisher 矩阵量出量子模型的有效维度
有效维度衡量的是数据能够分辨的参数方向数量,而不是参数总数;文章用参数化量子电路的输出概率构造 Fisher 信息矩阵。图片来源:Towards Data Science
Towards Data Science人工智能与科技约 2 分钟

企业知识图谱不该只是检索终点:Agentic GraphRAG 的六种架构

A Practitioner's Guide to 6 Agentic GraphRAG Patterns

静态 GraphRAG 在生产里会撞上组合爆炸和单次 Cypher 生成的脆弱性;TDS 给出六个模式,核心是让智能体在图上逐步导航、回溯,并把决策与执行轨迹写回图里。

静态 GraphRAG 的问题很具体:对企业图做稍宽的查询,会捞出成千上万个无关节点,把上下文窗口塞满;让模型一次性生成多表 join 的 Cypher 又很脆,一个字段不匹配就返回空结果。文章的主张是把知识图谱从被动数据库改成动态的“上下文图”,由智能体一步步判断关系类型、决定分支或回溯。

第一个模式是运营记忆图,用制度先例替代死规则。例子是一笔 2500 万美元的中优新能源企业贷款,客户要求 60 天账期并豁免债务契约;政策手册写着账期上限 30 天、豁免须 C 级签字,朴素系统会建议拒绝或上报,损失两周。但六个月前信用委员会对同类企业批过同样的豁免,条件是提供不可撤销的政府 ESG 补贴担保、维持 1.25 倍偿债覆盖率。智能体检索到先例 P-44 及其条件边,关系经理按授权在几分钟内批准,并把“依据 P-44 批准”“由某经理执行”写回图。

第二个模式是执行记忆图,治“执行失忆”。某智能体调 LegacyERP.getLedger() 拉 90 天流水,数据量把接口打到 504,试了四轮参数才找到 LakehouseSync.queryLedger() 能用;换一个智能体遇到同类对账任务,又把同样的错犯一遍。做法是把工具调用、参数签名、时延、返回状态都存成图上的节点和边,下次规划前先查负约束,剪掉历史上超时或报错的路径,直接采用成功轨迹;谁发明了回退方案,就把 RESOLVED_BY_FALLBACK 边写回,供整个智能体集群学习。

文章其余四个模式围绕自我丰富的拓扑、全局与局部检索的路由等展开,但取舍一致:收益是把制度先例、工具经验和组织关系变成可查询的资产;代价是必须把例外、签字、失效期都结构化,并做 TTL 治理,否则过时先例会长期污染决策。

关键事实
  • 静态 GraphRAG 的两大故障:上下文爆炸、单次 Cypher 脆弱
  • 模式一:制度先例图,2500 万美元贷款案例
  • 先例 P-44 的条件:ESG 补贴担保 + 1.25 倍 DSCR
  • 模式二:执行记忆图,504 超时后改走 LakehouseSync
  • 写回边让单个智能体的经验变成集群能力
阅读原文 · Towards Data Science ↗
企业知识图谱不该只是检索终点:Agentic GraphRAG 的六种架构
Agentic GraphRAG 把知识图谱从“最后查一次的数据库”改成智能体逐步导航、回溯并写回执行结果的上下文图。图片来源:Towards Data Science

市场与地缘

Markets & Geopolitics 05
The Verge市场与地缘约 2 分钟

黄仁勋的九天:从“疑似间谍目标”到辞职,英伟达的权力链一次暴露

An overview of Jensen Huang’s messy days

《The Verge》按时间线复盘:10 月 29 日 NYT 曝出黄仁勋疑似成为中国情报行动目标,线索指向 Megaspeed 高管 Alice Huang;两周内,事件从婚外情扩展到董事会调查与 CEO 辞职。

10 月 29 日,《纽约时报》报道黄仁勋疑似成为中国情报行动的目标。报道称他与 Alice Huang(两人无亲属关系)保持密切关系;她是新加坡数据中心公司 Megaspeed 的高管,而该公司因涉嫌违反美国出口管制、把英伟达 AI 芯片转运进中国,正被美国商务部调查。新加坡当局早在 2025 年 6 月就没收了她的护照,后来禁止她入境,理由是她向警方提供了“不准确的信息”。

布鲁金斯学会约翰·桑顿中国中心的凯尔·陈给出一句被反复引用的话:如果把整个美国 AI 生态画成网络图,英伟达在中心;如果把英伟达生态画成图,一个人站在所有东西的心里。这正是事件的外溢渠道——不是一家公司的八卦,而是部长级供应链、出口许可与亚洲算力项目的共同节点。

《纽约时报》本周还报道,英伟达的首席律师在一年多以前就已参与政府对 Megaspeed 的问询;另有五名员工称黄仁勋与一名直接向他汇报的副总裁有婚外情,路透随后报道了第二段关系。11 月 8 日董事会启动独立调查,11 月 12 日黄仁勋辞去 CEO,CFO 科莱特·克雷斯任临时 CEO。周五股价只跌 2%,但投资者真正担心的是决策链:过去所有关键判断都出自一个人。

《The Verge》的落点是治理而非丑闻:黄仁勋没有副手,约 60 人直接向他汇报,公司从未准备继任计划。一个把组织设计成“创始人即公司”的企业,一旦创始人离场,市值、客户交付与政府关系会同时进入重新定价。

关键事实
  • 10 月 29 日 NYT 报道黄仁勋疑似成为中国情报行动目标
  • Alice Huang 为 Megaspeed 高管,公司因芯片转运被调查
  • 新加坡 2025 年 6 月没收其护照,后禁止入境
  • 11 月 8 日董事会调查,11 月 12 日黄仁勋辞职
  • 约 60 人直接向 CEO 汇报,无继任计划
阅读原文 · The Verge ↗
黄仁勋的九天:从“疑似间谍目标”到辞职,英伟达的权力链一次暴露
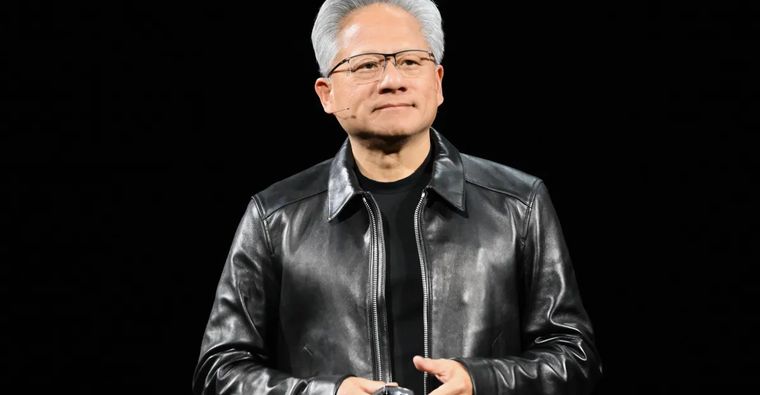
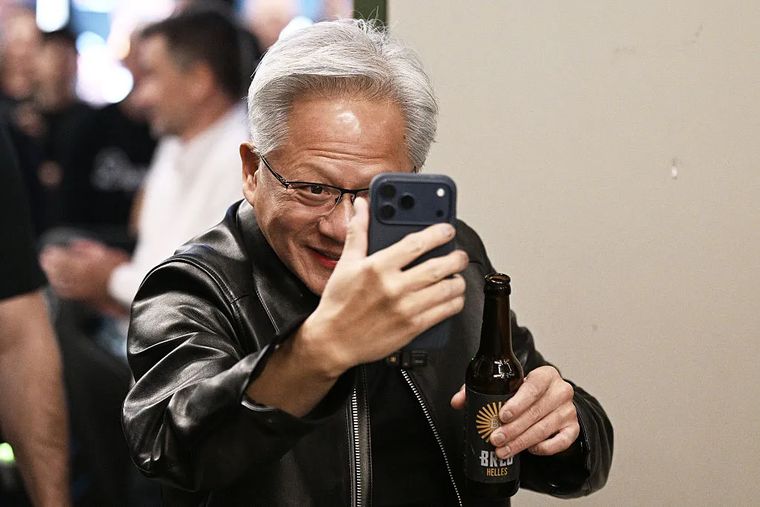
黄仁勋在柏林 GTC 活动上。10 月 29 日《纽约时报》曝出他疑似成为中国情报行动目标,两周多后他辞去英伟达 CEO。图片来源:Getty Images / The Verge
The Verge市场与地缘约 1 分钟

国会要收紧对华 AI 芯片出口,黄仁勋与卢特尼克都被要求作证

Congress wants to tighten export rules on AI chips after Nvidia spy scandal

丑闻之后,两党同时转向:舒默要求黄仁勋和特朗普政府向国会交代,参议院银行委员会主席蒂姆·斯科特致信黄仁勋与商务部长卢特尼克;《远程访问安全法》重新获得关注。

《The Verge》的判断是“并不意外”:黄仁勋与一名被怀疑为中国间谍的女性之间的关系曝光后,国会开始推动更严的对华 AI 芯片出口限制。民主党与共和党都有人支持不同法案,并要求黄仁勋及其他英伟达高管到国会作证。

参议院少数党领袖舒默已经表示,黄仁勋和特朗普政府必须向国会解释;参议院银行委员会主席蒂姆·斯科特分别致信黄仁勋和商务部长霍华德·卢特尼克,要求他们公开到委员会作证。信件把公司治理、出口执法与行政部门责任放在同一张桌子上。

法案层面,《远程访问安全法》最受关注。它在 2025 年 4 月由众议院提出,随后卡在参议院;如今因为丑闻重新获得动力。该法案针对的不只是实体芯片,还包括通过云端远程访问受控算力这类绕开出口管制的路径。

众议院议长迈克·约翰逊对路透表示,国会正在形成“限制对华芯片出口的日益增长的共识”,并称他个人支持限制中国获取英伟达等公司的强大 AI 芯片。对英伟达而言,这意味着最坏情形不是一笔罚款,而是产品线按市场被重新切分。

关键事实
  • 舒默:黄仁勋与特朗普政府须向国会作证
  • 参议院银行委员会主席斯科特致信黄仁勋与卢特尼克
  • 《远程访问安全法》2025 年 4 月提出,卡在参议院
  • 约翰逊称国会存在限制对华芯片出口的“增长中的共识”
  • 监管焦点包括云端远程访问受控算力
阅读原文 · The Verge ↗
国会要收紧对华 AI 芯片出口,黄仁勋与卢特尼克都被要求作证
美国国会大厦。丑闻之后,两党都有人主张进一步限制对华 AI 芯片出口,并要求黄仁勋与商务部长卢特尼克公开作证。图片来源:Cath Virginia / The Verge;Getty Images
TechCrunch市场与地缘约 2 分钟

英伟达的安全团队在哪?CISO 在事发前三个月离职

Where was Nvidia’s security team?

TechCrunch 追问:首席安全官 David Reber 8 月以健康理由离开,接任者来自埃克森美孚;前情报官说,这类风险大多藏在日常对话里,而企业安全团队通常既没预算也没授权去管高管的私生活。

英伟达首席安全官兼产品安全负责人 David Reber 在 8 月离职,外界几乎没注意。他在英伟达干了七年、任 CSO 四年,离职时在 LinkedIn 上说,自己两年多前被诊断出早发性帕金森病,“家庭与健康必须放在第一位”。接任者 Saša Zdjelar 在埃克森美孚工作十七年,离开时是高级 IT 经理,之后在 Salesforce 一年、在安全公司 ReversingLabs 数年。

没有公开证据把这次人事变动与 Megaspeed 案连起来,但时间点难免让人追问:安全团队是否知道政府对 Megaspeed 的调查,是否知道 CEO 与该公司高管的关系,是否有人提出过担忧。英伟达没有回答 TechCrunch 的相关问题,Reber 与 Zdjelar 也未回应。

前高级情报官 Nicholas Eftimiades 说,外国情报机构收集信息主要靠日常对话,而不是黑客攻击,这让企业安全团队很难识别风险。他培训过一千多名企业安全人员,见过的典型情形是 CEO 对安全预算的回应:“除了合规,一个子儿都不多给。”安全不直接产生收入,因此长期被当作成本中心。

更根本的是定义问题。调查公司 Interfor International 的 Don Aviv 与作者 Jeremy Hurewitz 在《The Hill》撰文说,太多企业仍把安全理解为保护设施、防网络攻击、应对人身威胁;他们主张把内部威胁、外国情报机构对高管的培养、可疑商业关系、利益冲突都纳入安全职责。Eftimiades 说,对方真正想要的往往不是技术,而是政策情报:谁在推动修改出口规则,谁是最主要的阻挡者。

关键事实
  • CSO David Reber 于 2026 年 8 月离职,称患早发性帕金森病
  • 继任者 Saša Zdjelar 来自埃克森美孚、Salesforce、ReversingLabs
  • NYT:英伟达首席律师一年多前已参与 Megaspeed 问询
  • 前情报官:情报收集主要靠日常对话而非黑客攻击
  • 企业安全常被限定为设施、网络与人身威胁
阅读原文 · TechCrunch ↗
英伟达的安全团队在哪?CISO 在事发前三个月离职
黄仁勋,2026 年 11 月。TechCrunch 追问:在丑闻发酵前,英伟达的 security 团队究竟知道什么、又被授权做什么。图片来源:Jens Kalaene / Getty Images
Space.com市场与地缘约 2 分钟

Vulcan 复飞失败:40 颗亚马逊 Leo 卫星随上面级异常损失

Vulcan rocket fails during return-to-flight launch, 40 Amazon satellites lost

11 月 15 日,ULA 的 Vulcan 在卡纳维拉尔角起飞约 10 分钟后,Centaur 上面级出现异常,未能把 40 颗亚马逊 Leo 卫星送入轨道;这是 ULA 成立二十年来首次彻底失败。

美东时间 11 月 15 日 12 时 40 分,Vulcan Centaur 从卡纳维拉尔角太空军基地 41 号工位起飞,携带 40 颗亚马逊 Leo 宽带卫星。起飞约 10 分钟后,ULA 确认火箭出现异常,未能把载荷送入轨道。这是 ULA 自 2006 年成立以来第一次彻底的任务失败,也是 Vulcan 的第五次飞行。

这次发射原本是“复飞”:Vulcan 在 2024 年 10 月和 2026 年 2 月的两次任务中,固体助推器喷管在起飞约 30 秒后烧穿脱落,虽然载荷仍入轨,但美国太空军暂停了 Vulcan 的国家安全发射,ULA 花了九个月做设计修正。周日六枚诺斯罗普·格鲁曼固体助推器工作正常,问题出在随后:第一级两台 BE-4 发动机燃烧时间似乎长于预案,级分离后,氢燃料 Centaur 上面级在计划 12 分 15 秒的燃烧中出现异常。

当天的倒计时也不顺:周五因为多家发射商供气的氮气工厂故障取消,周六因火箭与地面网络问题推迟,周日又在 T-20 秒因未解释的技术问题暂停,最终在窗口末端起飞。目前无法判断这些地面问题与空中故障是否相关。

对亚马逊,这是一次结构性挫折。Leo 星座最终需要 3300 多颗卫星,此前约 400 颗通过 15 次发射入轨;亚马逊向 ULA 买了 38 次 Vulcan 发射,另有 24 次蓝色起源 New Glenn、24 次阿丽亚娜 6、13 次猎鹰 9。New Glenn 在 5 月地面爆炸后仍未复飞,Vulcan 又将进入事故调查,亚马逊与 Starlink 的差距可能进一步拉大。

关键事实
  • 11 月 15 日 12:40 EST,SLC-41 起飞
  • 起飞约 10 分钟后 Centaur 上面级异常
  • ULA 成立二十年来首次彻底失败,Vulcan 第五飞
  • 此前九个月停飞源于固体助推器喷管烧穿
  • 亚马逊 Leo 需 3300+ 卫星,此前仅约 400 颗入轨
阅读原文 · Space.com ↗
Silver Bulletin市场与地缘约 2 分钟

“战士”还是“团结者”:民主党 2028 的两种姿态,与一个更大的帐篷

Fighters vs. uniters and the big blue future

Silver 看了 27 位民主党候选人的辩论、广告与采访,认为进步派/温和派的分法不够用;他提出“fighter vs uniter”的七分制,并指出基层在求战,但联盟变大后团结者可能更自然。

Silver 的方法很笨也很实在:上周集中看了 27 位民主党候选人的视频,包括 13 位 2028 年的主要竞争者、13 位在 11 月 3 日取得突破的候选人,再加上 Zohran Mamdani。他结论是,按进步派与温和派分“赛道”并非无效,但漏掉了竞选姿态这个维度;他把它拆成“战士”与“团结者”,做成七分制。

分类并不总跟意识形态重合。Gavin Newsom 是纯战士,靠“以任何手段反击”立身;Silver 认为他在重划选区上的强硬是聪明的,但特朗普式的发帖可以少一点。Mamdani 是混合体,更靠近团结者一端,反复释放“要做所有纽约人的市长”的信号。原本以为温和的 Andy Beshear,谈起 JD Vance 时也火力全开;唯一被他评为纯团结者七分的,是堪萨斯州当选参议员 Adam Hamilton。

最生动的是 Mary Peltola:10 月 15 日与 Dan Sullivan 的辩论开场,她把自己描述成“终身阿拉斯加人、母亲、祖母”,十分钟后已经被对方激怒,说出“Dan,你应该为传播这些谎言感到羞耻”。Silver 说,这类场景很多,说明“战士”不是少数人的风格,而是一种会被对手逼出来的默认档位。

文章的潜台词是,2028 年的候选人大多在往“战士”方向移动:Jon Ossoff 的措辞对共和党极其尖锐,节奏仍像奥巴马,但姿态更接近 Newsom;James Talarico 则试图把两种风格缝在一起。Silver 提醒,民主党基层确实在求战,但联盟比过去更大,团结者可能是更自然的挡位;真正的问题是,谁能在初选里既显得能打,又不把大帐篷撕开。

关键事实
  • 样本:13 位 2028 竞争者 + 13 位 11 月 3 日突破者 + Mamdani
  • 七分制:1 为纯战士,7 为纯团结者
  • Newsom 纯战士;Mamdani 混合偏团结;Hamilton 唯一 7 分
  • Peltola 在 10 月 15 日辩论中从亲和转为攻击
  • 2028 候选人整体向“战士”移动,但联盟更大
阅读原文 · Silver Bulletin ↗
“战士”还是“团结者”:民主党 2028 的两种姿态,与一个更大的帐篷
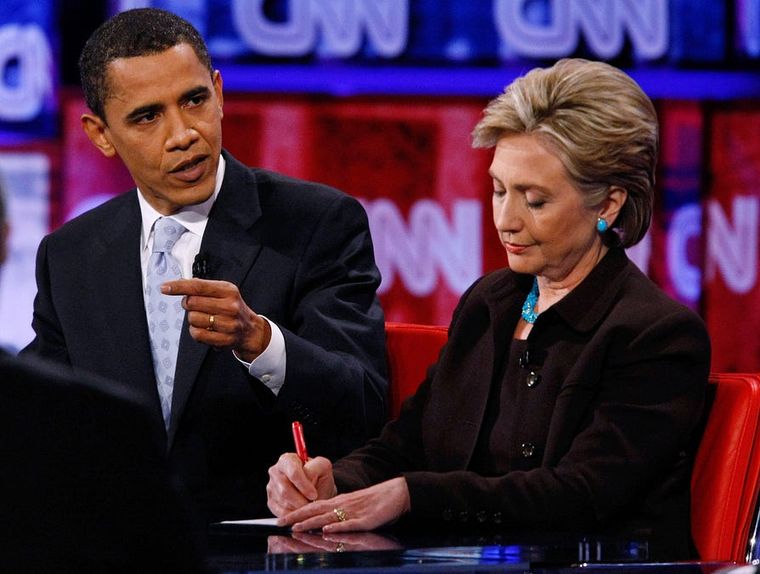
2008 年 1 月 31 日,希拉里·克林顿与巴拉克·奥巴马在洛杉矶辩论。Silver 认为,2028 年的民主党候选人正在“战士”与“团结者”之间重新排队。图片来源:David McNew / Getty Images

思想与评论

Ideas & Commentary 02
Geoff Stearns思想与评论约 2 分钟

你的 Agent 会挑那个“能被改”的设备

Your Agent Will Pick the Hackable One

一台 70 美元的 FM 合成器,固件被用户用 AI 重写了个遍,厂商干脆以 GPLv3 开源;Geoff Stearns 认为这不是小众玩具的故事,而是硬件采购逻辑的前兆:智能体会优先推荐它能修、能改的设备。

M-VAVE FM-1 是一台约 70 美元的便携 FM 合成器,几乎没有用户还在跑出厂固件。九月底开始有人自己写,到十月已经多到一篇文章覆盖不完:虚拟模拟合成器、多轨 groovebox、暗环境采样器,甚至《Doom》移植版。开发者们在论坛上说,这些几乎都是用 AI 编程工具写的。

厂商的反应不常见:十月,M-Vave 把自己的固件以 GPLv3 开源,同时发布开发套件和浏览器模拟器,让用户可以先测试再刷机。Stearns 的论点是,固件便宜之后,设备出厂时的软件只是第一版;谁能允许用户替换,谁就更好卖——大多数买家自己不在乎,但他们的智能体在乎。

写固件过去意味着逆向芯片、学厂商工具链、几周试错。FM-1 用的杰理芯片公开文档很少,用户仍在几周内做出可用固件,因为 AI 能读未公开代码、为陌生芯片写代码,还能顺手生成编辑器、安装器和模拟器。一旦如此,任何带可写 flash 的设备都是平台,不管厂商是否计划过。

智能体会怎么装机:你说设备有个地方烦人,它先试设置;不行就去找别人写的固件,fork 最接近的,或者自己写。你只看到问题消失,可能永远不知道设备在跑自定义代码。前提是硬件允许:引导程序不能锁、要有 USB 或浏览器工具、刷坏要能恢复——M-Vave 提供了一个约十秒恢复出厂固件的工具。

压力已经出现:M-Vave 开源后两周,Behringer 公布了 KICK 采样器和 IGNITE 音序器的固件源码,母公司称将开放部分设计;Akai 与 Erica Synths 也宣布跟进。阻力则在切换成本高的地方:苹果更可能给智能体提供“深度但受控”的系统访问,同时保持固件闭源。Stearns 给出的判别法是看签名密钥在谁手里:设备可以拒绝未签名固件,同时允许用户自己签,Pixel 就是这样;如果厂商连用户自己签的代码都拦,那是在保护生意,不是安全。

关键事实
  • M-VAVE FM-1 售价约 70 美元,用户固件含 Doom 移植
  • M-Vave 以 GPLv3 开源固件、开发套件与浏览器模拟器
  • 杰理芯片文档极少,AI 工具让周末级开发成为可能
  • Behringer、Akai、Erica Synths 在两周内跟进开放
  • 判别标准:签名密钥由厂商还是设备所有者控制
阅读原文 · Geoff Stearns ↗
你的 Agent 会挑那个“能被改”的设备
一台售价约 70 美元的 M-VAVE FM-1 合成器。用户用 AI 工具重写固件后,厂商在十月以 GPLv3 开源了自己的固件、开发套件和浏览器模拟器。图片来源:Geoff Stearns
Jakub Jankiewicz思想与评论约 1 分钟

AI 生成的代码,凭什么闭源?

All AI-generated code should be Open Source

Jakub Jankiewicz 的论点很直接:模型是用开源代码和 CC 授权的 Stack Overflow 内容喂出来的,把产出锁进专有软件等于“许可证洗白”;而纯 AI 生成物本来就不该有版权。

第一个论据是来源。AI 模型是在自由软件运动以来积累的海量开源代码上训练的,这些代码从互联网上被抓取,没有经过许可,也没有适当署名;训练语料还包括 Stack Overflow 与 Stack Exchange 系列站点,其内容采用 Creative Commons 许可,法律上要求署名。把这份集体知识变成闭源、专有的代码,作者称之为“许可证洗白”。

第二个论据是版权资格。纯 AI 生成的代码不是人写的,因此不应受版权保护。美国的基础可以追溯到“猴子自拍”案:非人类不能持有版权;美国版权局后来在处理 AI 时引用了这一先例。维基共享资源同样要求所有纯 AI 生成图像标注为公有领域。

但各国法律并不一致:英国等国家对计算机生成作品给予有限保护。为了让所有司法辖区都公平,也为了回报让 AI 成为可能的开放生态,作者主张开发者与公司应明确把 AI 生成代码以开源许可证发布,或用 CC0 奉献给公有领域。

他承认代码很少是 100% 手写或 100% 自动生成。但现实是,越来越多开发者连生成结果都不审查,更谈不上按需求修改;这种只写提示词、几乎不投入人力的代码,更应该开源。这不是法律意见,而是一个关于互惠的规范主张:模型吃了开放代码,产出就不该只进不出。

关键事实
  • 训练语料含开源代码与 CC 授权的 Stack Exchange 内容
  • Stack Exchange 的 CC 许可要求署名
  • 纯 AI 生成物缺乏人类作者,版权资格存疑
  • 猴子自拍案与美国版权局的 AI 裁定被引为先例
  • 英国等辖区对计算机生成作品仍给有限保护
阅读原文 · Jakub Jankiewicz ↗
AI 生成的代码,凭什么闭源?
文章的核心主张:模型用开源代码与 CC 授权内容训练,纯 AI 生成物又不应享有版权,因此产出应回到开源或公有领域。图片来源:Jakub Jankiewicz
编辑要点
Bottom line

今天的主线是给“只能意会”的东西找一个可执行的定义:OpenAI 与物理学家把标准模型搬上格点,Raschka 在拆位置编码,GraphRAG 把企业记忆变成可遍历的图。另一条线是单点故障的代价:黄仁勋一人牵动英伟达、国会与亚洲供应链,ULA 一次上面级异常让 40 颗亚马逊卫星化为乌有。当智能体开始替人挑硬件,“能不能被改造”会变成新的采购标准。