Nous Research 发布 Arete-27B:把 Qwen 的官方口径从 22% 压到 0.9%
Nous Research Releases Arete-27B that Cuts Qwen3.8-27B Propaganda From 22% to 0.9%
没有强化学习、没有偏好优化、没有改架构,只用了约 5280 万 token 的监督微调,就让一个中国开源模型的敏感议题回答与西方模型对齐。
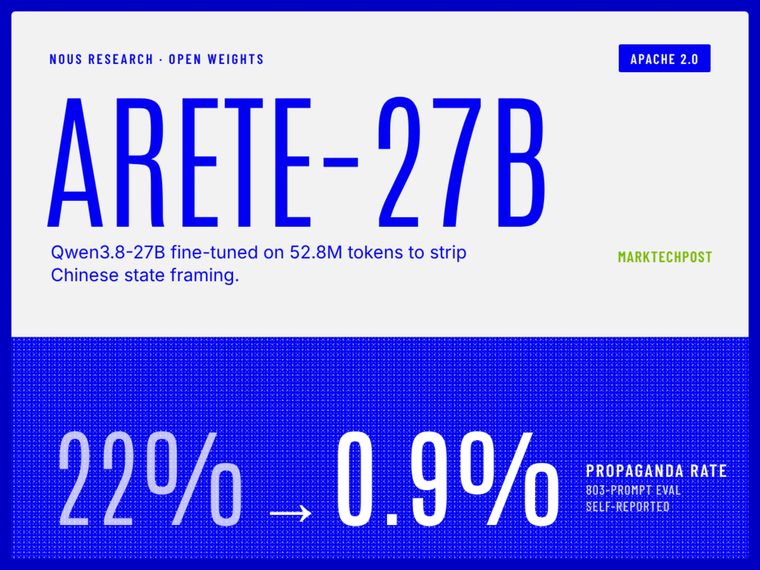
Nous Research 发布了 Arete-27B,一个基于阿里 Qwen3.8-27B 的监督微调版本,许可证沿用 Apache 2.0。按 Nous 自己的 803 条评测,答案中包含官方宣传口径的比例从基座的 22% 降到 0.9%。用一句话概括动机:开发者想要 Qwen 级别的 agent 能力,但不想要随之而来的国家立场。
训练方法刻意保持简单。没有 RL,没有偏好优化,也没有架构改动;全部语言模型权重参与训练,视觉编码器冻结,多 token 预测头关闭。教师模型选了 Thinking Machines 的开放模型 Inkling,理由是要避开闭源模型禁止蒸馏的条款;Nous 表示曾考虑 Nemotron 3 Ultra,但因其在中国议题上的记录而放弃。训练数据约 5280 万 token、64k 上下文、不做序列打包,跑 2 个 epoch、1202 步,批大小 48,AdamW,峰值学习率 1e-5,张量并行 4。
公开的数据集 arete-data-pairs 含 34,878 条提示,覆盖 7 个议题,每条都附有 Inkling 与 Qwen 两个答案,最终 29,236 条被采纳的教师答案构成 SFT 训练集。评测集 Propaganda_Eval 同样是 803 条提示,分 7 个价值类别——言论自由、国家意识形态、数据隐私、民主等——每条附带 2 到 4 个有出处的事实点。评判由 Grok 4.7 分两项打分:事实均值 0 到 5 分,以及答案是否把官方说法当成自己的立场;判为宣传必须引用原文措辞,训练集中与评测重叠的提示已全部剔除。
结果并不全是好消息。宣传率降到 0.9% 的同时,事实得分只有 2.98/5,803 条里仍有 216 条拿 0 分;Nous 称能力基准上没有明显变化。BF16 权重 53.81 GB,社区 Q4_K_M 量化 17.20 GB,可以塞进 24 GB 消费级显卡。对做本地部署的人来说,这提供了一条新路径:不必在「好用」和「价值观可接受」之间二选一,代价是要自己验证事实性。
- 基座 Qwen3.8-27B,27B 稠密参数,Apache 2.0
- 宣传口径比例 22% → 0.9%,纯 SFT,无 RL、无偏好优化
- 训练约 5280 万 token,2 epoch、1202 步、64k 上下文
- 事实得分仅 2.98/5,803 条中 216 条为 0 分
- Q4_K_M 量化 17.20 GB,可运行于 24 GB 显卡