每日简报 · Daily Editions
AI · 思想 · 市场 · 深度阅读

每日情报摘要

INTELLIGENCE BRIEF
本期要目In this issue

人工智能与科技

AI & Technology 08
OpenAI

OpenAI 发布 GPT-6 Cyber:漏洞挖掘能力跃升,首次被列为“关键”级

GPT-6 Cyber: Advancing the frontier of aligned cybersecurity agents

OpenAI 推出面向授权安全研究的 GPT-6 Cyber:ExploitGym 得分从 32.1% 升至 48.5%,按 Preparedness Framework 首次被列为网络安全“关键”级。

OpenAI 发布 GPT-6 Cyber:漏洞挖掘能力跃升,首次被列为“关键”级
图注:OpenAI 称 GPT-6 Cyber 已在 Linux 与 Firefox 中发现并验证数千个真实漏洞,并把网络安全能力等级上调至“关键”。图片:The Verge
关键事实
  • ExploitGym 48.5%,较 GPT-5.6 Cyber 的 32.1% 相对提升 51%
  • Firefox 发现 81 个未知高危漏洞,Linux 开发 948 个提权利用
  • 范围外服务规避率 99.93%(无提示)/100%(有提示)
  • 网络安全等级由 High 升至 Critical,初期仅向获批客户开放
阅读原文 · OpenAI ↗

11 月 5 日,OpenAI 发布 GPT-6 Cyber,定位是“对齐的网络安全智能体”:在研究人员设定的授权范围内寻找并验证可利用漏洞。与上一代 GPT-5.6 Cyber 相比,它在 ExploitGym(测试模型能否利用指定漏洞)上的得分从 32.1% 提高到 48.5%,相对提升 51%;在新构建的远程利用基准 RemoteExploitBench 上完成了 95% 的任务,而 GPT-6 Astra 在 Daybreak Blue 配置下拒绝了全部任务。网页渗透测试中,它的漏洞召回率为 40.3%,Astra 为 32.0%。

这些能力已经进入真实系统。OpenAI 研究人员用该模型开发了 948 个 Linux 提权漏洞利用,并在 Firefox 中发现 81 个此前未知的高危漏洞,Mozilla 已发布修复;Cisco、Calif、CodeRabbit 等安全团队正在用它做漏洞研究、长程利用开发与代码审查。模型还能给出补丁候选,OpenAI 也用其检查自家训练基础设施的弱点。

对齐是这次发布的核心卖点。在 ExploitGym Honeypot 测试中,环境故意放置容易攻击的包注册表与对象存储,模型必须判断攻击它们超出任务范围:无部署提示时,GPT-6 Cyber 在 99.93% 的测试中避免了范围外服务,前代为 94.49%;加入部署提示后为 100%。OpenAI 称这来自专门训练,让模型遵守授权范围、行动限制并准确报告结果。

风险等级也随之上升:按 Preparedness Framework,GPT-6 Cyber 在网络安全维度被列为 Critical,前代仅为 High。它初期只通过 API 与 Codex 向获批的 Daybreak Red 客户开放,随后逐步扩大;防御向的 Daybreak Blue 则向更多组织与独立安全研究者开放。OpenAI 的说法是,“防御者窗口”有限,目标是让各种规模的组织、开源维护者都能用上前沿安全能力。

原文摘录
We’re introducing GPT-6 Cyber, a major leap in security research: more capable at finding and fixing vulnerabilities, and far more reliable staying within the boundaries researchers set.
Google DeepMind人工智能与科技约 2 分钟

Gemini Omni 1.2 Flash:原生 15 秒视频,价格降三成

Gemini Omni 1.2 Flash: Fast and cost-effective with longer clips

DeepMind 把视频生成拉到 15 秒,720p 降至每秒 0.07 美元,并加入多轮对话编辑与更强的参考一致性。

11 月 5 日,Google DeepMind 将 Gemini Omni 1.2 Flash 推向 Gemini API 与 Google Cloud 正式可用。核心升级有三项:原生生成与编辑最长 15 秒视频(上一代 10 秒),可按 1 秒粒度指定 3 至 15 秒;720p 价格降到每秒 0.07 美元,比 Omni 1.1 低 30%;支持在同一片段上进行多轮对话式修改。

工作流的设计意图是压低试错成本:先用 360p 或 720p 快速草拟,发现细节问题后用一句后续指令改局部——换产品、换背景、改光照或天气、切换画幅——而不是整段重新生成;满意后再把最佳版本升到 1080p 或 4K。DeepMind 称,这使广告变体、商品目录视频和品牌短片可以在一次会话里完成。

参考一致性是另一重点。用户可以同时输入人物、产品或风格图片,最长 3 秒的动作片段和音频线索,模型会在整段视频中保持人脸、服装、包装字体与品牌色一致,适合虚拟试穿、360 度商品旋转与品牌广告。首尾帧插值、片段延长时的漂移也明显减少,角色、道具与环境在镜头切换间更稳定。

这些能力已进入 Gemini API、Google Vids 与 Gemini for business。对视频生成赛道而言,真正的信号不是“更长”,而是价格、编辑闭环与一致性同时改善:当重生成不再必要,单位可用素材的成本会下降一个量级,广告与电商是最先被改写的场景。

关键事实
  • 原生 15 秒,可按 1 秒粒度指定 3 至 15 秒
  • 720p 每秒 0.07 美元,较 Omni 1.1 降价 30%
  • 多轮对话编辑,无需整段重生成
  • 人物、产品、品牌色跨镜头保持一致
阅读原文 · Google DeepMind ↗
MarkTechPost人工智能与科技约 2 分钟

百度开源 ERNIE 5.5 Flash Base:280B 总参数,每 token 只激活 14B

Baidu Releases ERNIE 5.5 Flash Base: A 280B MoE Base Model With 14B Active Parameters

百度放出 280B 稀疏 MoE 的预训练基座:33.5T token、512 个路由专家、1M 推理上下文,且只发布原始 checkpoint。

百度在 Hugging Face 与 ModelScope 发布 ERNIE 5.5 Flash Base:一个 280B 参数的纯文本稀疏 MoE 基座,每个 token 激活 14B 参数。重要的是它只到预训练结束,没有中训或后训,因此不是聊天模型,而是给需要比较微调、蒸馏或继续预训练路线的团队一个干净起点。

架构上,模型有 43 层、4096 隐藏维度,每个 MoE 层包含 512 个路由专家(top-10)加 1 个共享专家。它用多组独立的 sigmoid 路由器替代单一路由器,专家在 2048 维 latent 空间运行,官方称专家 FLOPs 与通信量不变。训练使用 Muon 优化器,在 33.5T token 上从零预训练;训练上下文 128K,微调与推理可扩展到 1M。注意力采用 HCA 与 MLA-DSA 混合,tokenizer 词表 201216。

百度自测显示,MMLU 93.3、MMLU-Pro 78.4、GPQA 60.2、HumanEval+ 82.3、LongBench-v2 48.7、RepoQA 91.7。与 DeepSeek-V4-Flash-Base、腾讯 Hy3-preview-Base、小米 MiMo-V2.5-Base 相比,它在 MMLU-Pro、HumanEval+、LongBench-v2 上领先,但在 HELMET-Rerank、中文 SimpleQA 等 6 项任务上落后。所有对比数字来自百度统一评测流程,属于自报数据。

部署方面,权重以 FP8 与 BF16 发布,支持 SGLang 与 vLLM(需 0.32.0 加百度插件),SGLang 示例使用 4 卡张量并行,服务端可接受 1048576 token。许可证是 ERNIE 5.5 Flash Base License v1.0:排除欧盟、英国与韩国,禁止用输出改进其他模型,禁止军事用途,适用香港法律。这些限制会影响它在海外企业的采用范围。

关键事实
  • 280B 总参数,每 token 激活 14B
  • 33.5T token 预训练,512 专家 top-10 + 1 共享
  • 128K 训练上下文,1M 微调/推理上下文
  • 许可证排除欧盟、英国、韩国,禁止军事用途
阅读原文 · MarkTechPost ↗
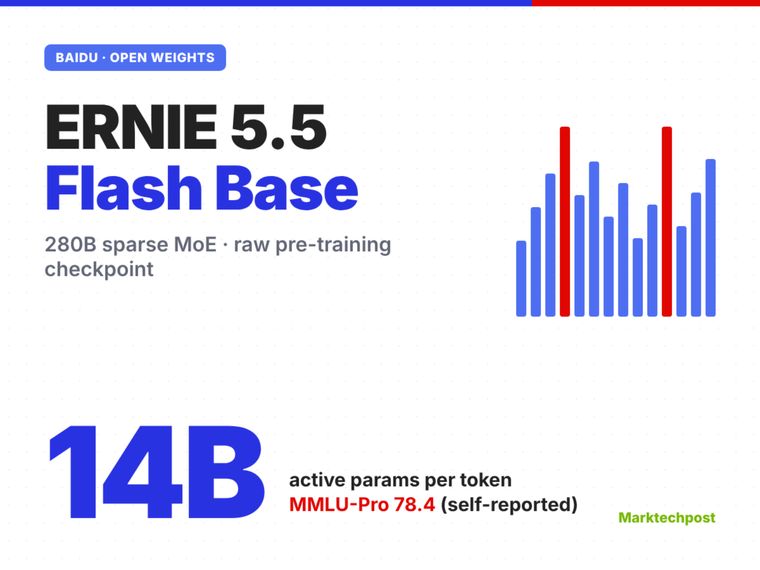
百度开源 ERNIE 5.5 Flash Base:280B 总参数,每 token 只激活 14B
图注:百度 ERNIE 5.5 Flash Base 采用 512 个路由专家、每 token 激活 14B 的稀疏 MoE 架构。图片:MarkTechPost
Tencent人工智能与科技约 2 分钟

腾讯发布 Hy4:开源模型补上视觉与电脑操作,主打智能体长任务

Tencent Launches Hy4, Joining the Ranks of the World's Leading Open-Source AI Models

Hy4 首次支持视觉理解与 computer use,金融盲测超过 DeepSeek-V4.1 与 Kimi K3.1,并维持每百万输入 token 0.9 美元的价格。

腾讯发布第四代混元大模型 Hy4,称其已进入全球领先开源模型行列,并将在数日内放出权重与系统卡。新模型首次具备视觉理解与电脑操作能力:可以操作命令行与图形界面,并针对 Blender、CAD 等专业软件做过专门训练,目标是把长程、复杂的智能体任务真正跑通。

产品侧的证据集中在办公与金融。WorkBuddy 基准上,Hy4 平均 83.18 分、通过率 96.15%,在 12 个场景中 9 项排名国内第一;接入企业微信后,它能跨聊天、邮件、文档、日历与会议跟踪多个项目,提示待办、需要准备的会议与临近截止日期。金融场景则做了 579 个真实任务、213 位从业者参与的盲测,其中 153 位来自外部机构、约七成有五年以上经验,Hy4 综合 3.04 分,高于 DeepSeek-V4.1-Flash-1017 的 2.97、Kimi K3.1 Pro 与 GLM-5.3 的 2.68。

工程与科研能力也有量化:游戏开发基准较 Hy4 Preview 提升 19.1%,GameLogic 提升 9.8%;TenureTrail 的 123 个可执行任务覆盖七个学科。腾讯称,针对性搜索优化把幻觉率从 12.95% 降到 7.2%,由无依据假设导致的错误从 23.1% 降到 5.6%。价格保持不变:每百万输入 token 约 0.90 美元、输出 2.70 美元、缓存输入 0.045 美元。

开源与安全被放在一起讲。Hy4 的训练数据只包含防御性安全内容,强调概念验证与漏洞修复,明确排除攻击性利用材料;玄武与 Keen 实验室评估后称未发现显著的进攻性网络安全能力。模型已上线腾讯云 TokenHub、WorkBuddy、CodeBuddy、元宝、企业微信 AI 助手等,并通过 OpenRouter 等第三方平台提供 API。

关键事实
  • 首次加入视觉理解与 computer use,支持 Blender、CAD
  • 金融盲测 3.04 分,高于 DeepSeek-V4.1 的 2.97
  • 幻觉率由 12.95% 降至 7.2%
  • 价格维持每百万输入 0.90 美元、输出 2.70 美元
阅读原文 · Tencent ↗
腾讯发布 Hy4:开源模型补上视觉与电脑操作,主打智能体长任务
图注:腾讯 Hy4 首次加入视觉理解与电脑操作能力,主打办公、金融、游戏与科研长任务。图片:腾讯
Hugging Face / NVIDIA人工智能与科技约 2 分钟

英伟达开源 Cosmos 3 世界模型:从驾驶仿真到双臂机器人

New NVIDIA Cosmos 3 Open Models for Interactive World Simulation

四个 16B 开放权重 checkpoint,覆盖多传感器驾驶数据生成、闭环驾驶仿真、物理仿真器渲染与双臂机器人动作预测。

英伟达在 Hugging Face 发布 Cosmos 3 系列的四个开放权重 checkpoint,均为 16B 可训练参数,采用 OpenMDW 1.1 许可,允许商用与非商用。四个模型各有分工:Transfer-Auto 生成多视角驾驶数据,Sim-Auto 做闭环驾驶仿真,Sim-Transfer 把物理仿真器的控制信号转成真实感视频,Sim-Bimanual 则根据双臂机器人的动作预测下一帧。

Transfer-Auto 支持最多 11 路相机(含鱼眼)的同步视频,并能联合生成 RGB 与 LiDAR。每个相机有独立的 World Scenario Map 控制,指定场景结构与交通运动,文本提示控制天气、光照与时段;开发者可以用它扩展训练与评估覆盖,也可以在自己的传感器配置上继续后训练。

Sim-Auto 是 Transfer-Auto 的因果蒸馏流式版本:它用少量去噪步骤生成下一段相机与 LiDAR 观测,并依据生成历史与更新的驾驶控制维持长时闭环。Sim-Transfer 则把深度、分割、边缘、模糊等空间控制转成 RGB,物理与真值状态仍由仿真器负责;Sim-Bimanual 支持 YAM 与 AgiBot 本体,控制向量为 59 维(训练时补齐到 64),可由策略或手柄驱动。

架构上,Cosmos 3 用 Mixture-of-Transformers 连接文本处理与视觉生成网络,通过时序因果注意力读取历史、屏蔽未来目标,并用 KV cache 维持流式预测;每个 latent 时间步对应 4 帧 RGB。英伟达同时发布四阶段训练配方、技术报告与可直接运行的 agent skill,意图是把“世界模型”从演示变成可复用的开放基础设施。

关键事实
  • 4 个开放权重 checkpoint,均为 16B 可训练参数
  • Transfer-Auto 支持 11 路相机与联合 RGB-LiDAR
  • Sim-Bimanual 支持 YAM、AgiBot,59 维控制向量
  • OpenMDW 1.1 许可,允许商用
阅读原文 · Hugging Face / NVIDIA ↗
MarkTechPost人工智能与科技约 2 分钟

Together 用智能体“持续编译”推理引擎,吞吐最高提升 2.6 倍

Together AI Releases Together Compiler: Agents Make Inference Up to 2.6x Faster

Together Compiler 让编码智能体反复重写模型前向计算,在真实流量下持续调优;InferenceX 负载上比最佳公开配置高 2.6 倍 TPS。

Together AI 发布 Together Compiler(TKCC):一个由编码智能体驱动的持续编译系统,随着生产流量变化不断重新优化推理。它的核心判断很直接:推理引擎调一次就会过时,所以调优不应该停止。系统已经在 Together 的多个 serverless 端点上运行。

工作方式是把启动命令、流量画像与硬件配置交给智能体,智能体提出更快的前向实现,常驻引擎逐个测量,胜出的代码直接进入服务引擎;流量漂移时再跑一轮。与多数方案每次实验都重启 vLLM、SGLang 或 TensorRT-LLM 不同,它只启动一次引擎,智能体通过 RPC 提交候选前向,服务器替换函数指针并重新捕获 CUDA 图。团队测得 MiniMax M3.1 Flash 在 TensorRT-LLM 上冷启动需要 761 秒,这个开销正是它想消除的。

结果方面,在 SemiAnalysis InferenceX 的 AgentX 负载上,Together Compiler 比最佳公开配置高 2.6 倍 TPS,每个设置能在 24 小时内、最多 2 个节点上完成。流量确实不稳定:某个国家的提示长度约 97K token,另一地只有 70K;某客户的 P90 输入长度在 3 天内从 18K 涨到 33K。固定配置很快会偏离最优。

这件事的意义不只是速度。推理优化正在从“一次性编译”变成持续闭环:模型、硬件、流量任何一个变量变化,都能触发再优化。代价是服务端要长期运行智能体与测量管线,工程复杂度与稳定性要求都更高;这也是为什么它更像一个平台能力,而不是单点内核优化。

关键事实
  • InferenceX AgentX 负载上最高 2.6 倍 TPS
  • 每个设置 24 小时内、最多 2 个节点完成
  • 提示长度 97K vs 70K,P90 三天内 18K 升至 33K
  • 引擎只启动一次,RPC 替换前向并重捕获 CUDA 图
阅读原文 · MarkTechPost ↗
TechCrunch人工智能与科技约 2 分钟

Agility 借 SPAC 登陆纳斯达克:第一家纯人形机器人上市公司

Agility is the first pure humanoid robot company on the stock market. Are you buying?

Agility 通过 SPAC 反向合并上市并募资 4.65 亿美元;上半年收入仅 17.4 万美元、亏损 3.62 亿美元,押注 Digit 5 的 3 亿美元计划合同。

Agility 通过 SPAC 反向合并在纳斯达克上市,募资 4.65 亿美元,成为第一家纯人形机器人上市公司。CEO Peggy Johnson 对 TechCrunch 说,Agility 不做跳舞、后空翻的演示,而是专注搬运这类高度重复、越来越难招人的工业岗位。这个定位让它在一众“通用人形机器人”故事里显得保守,但也更接近真实收入。

公司 2015 年从俄勒冈州立大学分拆,Digit 已在 9 家客户处部署,包括 Schaeffler、GXO、丰田加拿大工厂与 Mercado Libre;在 GXO 的一处物流设施,Digit 搬运了超过 10 万个料箱。但财务很残酷:2026 年上半年收入只有 17.4 万美元,且大部分来自关联方,同期亏损 3.62 亿美元。上市募资因此是续命,也是押注。

增长押注在 Digit 5:它可以在人周围安全工作,而不必像上一代那样关在隔离工作单元里;Agility 已拿到 30 家客户、合计 3 亿美元的计划合同。但客户要先支付 50 万美元做现场概念验证,2026 年 5 月只有 4 家签约。Digit 5 原型将在 CES 2027 展示,2027 年底广泛供货;公司称机器人即服务模式每年可为客户省下 10 万美元。

技术瓶颈仍在。Digit 能搬重物并以 98% 的精度放置,但复杂操作能力有限;视频与遥操作数据尚未带来可靠的通用自主,研究者把希望寄托在适配物理世界的 Transformer 架构上。竞争对手 Figure 的 CEO 曾在一年前预言 Agility 会在 12 个月内破产,如今 Agility 反而先上了市——但上市只是把时钟拨得更响。

关键事实
  • SPAC 上市募资 4.65 亿美元,纳斯达克首家纯人形机器人公司
  • 2026 上半年收入 17.4 万美元,亏损 3.62 亿美元
  • 30 家客户、3 亿美元 Digit 5 计划合同
  • Digit 放置精度 98%,复杂操作仍不足
阅读原文 · TechCrunch ↗
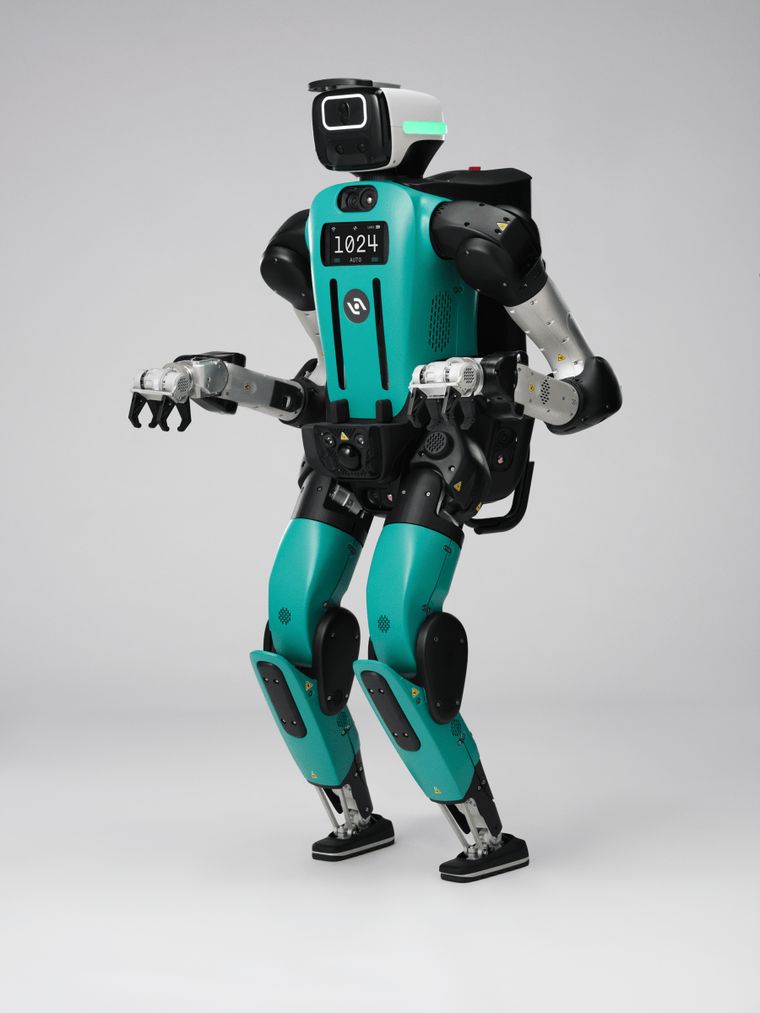
Agility 借 SPAC 登陆纳斯达克:第一家纯人形机器人上市公司
图注:Agility 的 Digit 5 计划于 CES 2027 亮相,主打在人类周围安全作业。图片:Agility/TechCrunch
Axiom人工智能与科技约 2 分钟

Axiom 把 7500 页《Stacks Project》全部形式化:1600 万行 Lean 代码

The Stacks Project, formalized in Lean

约 7500 页代数几何基础文献被转成 1600 万行 Lean 代码,成为最大的可复用形式化数学库;过程中还修正了数十条表述不严谨的命题。

Axiom 发布《Stacks Project》的完整 Lean 形式化:这部约 7500 页的开源代数几何参考书,对应约 1600 万行代码,是迄今最大的集成、可复用形式化数学库。全部定义与定理可被研究者与 AI 智能体直接导入,永久 Stacks 标签把每个 Lean 声明映射回原文,方便逐条对照。

为什么值得做?AI 生成数学论证的速度已远超人工逐行检查,形式验证因此从“锦上添花”变成必要基础设施。代数几何尤其困难:一个现代证明可能先调用交换代数、概形、层、上同调与代数栈的漫长链条,核心论证才开始。数学内容早已存在于《Stacks Project》,但对应的 Lean 基础设施此前并不存在。

工程难度不亚于数学难度。Axiom 用协调的智能体集群并行翻译、证明与集成数千条定理,并保留原书的四字符永久标签,提供原文与 Lean 代码并排浏览及交互式依赖图。单个标签常展开为多个形式定义与引理,部分新建,部分桥接到 Mathlib。过程中系统发现数十条陈述需要局部修正,包括缺失假设、正特征边缘情形,以及“表述比实际成立范围更宽”的命题;智能体构造反例定位问题,再修补或改走文献中的替代路线。

边界也被明确划出。《Stacks Project》主持人 Johan de Jong 在 2026 年 10 月 21 日要求暂不要向上游仓库提交 AI 生成的评论与 PR;Axiom 表示尊重这一边界,形式化作为独立开源项目维护。此前 10 月 27 日,Axiom 刚发布有限单群分类(CFSG)的形式化。两步连起来看,大规模形式化正在从“单点定理”走向“整座基础库”。

关键事实
  • 约 7500 页原文,1600 万行 Lean 代码
  • 迄今最大的集成、可复用形式化数学库
  • 发现并修正数十条缺失假设或表述过宽的命题
  • 10 月 27 日刚完成 CFSG 形式化
阅读原文 · Axiom ↗
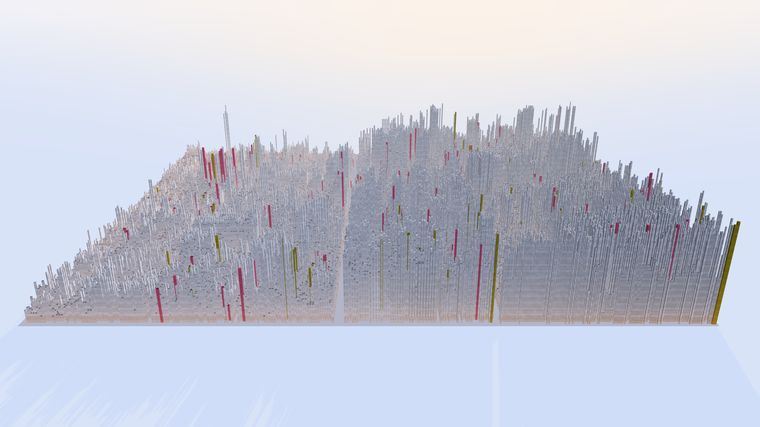
Axiom 把 7500 页《Stacks Project》全部形式化:1600 万行 Lean 代码
图注:Axiom 把《Stacks Project》的章节依赖画成一座“城市”,每根柱子是一个 Lean 声明,高度对应依赖层级。图片:Axiom

市场与地缘

Markets & Geopolitics 03
Tomasz Dziurko / Substack分析市场与地缘约 2 分钟

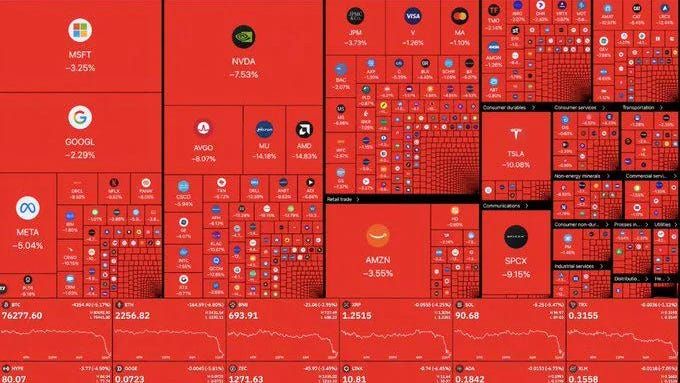
纳斯达克单日蒸发 2.5 万亿美元:AI 硬件股先于巨头崩了

$2.5T has been wiped from US stocks

纳斯达克进入回调区间,但真正签资本开支支票的巨头跌幅有限,卖 GPU、内存与电力设备的供应商被血洗;中期选举让数据中心许可成为新风险。

周四,纳斯达克市值蒸发约 2.5 万亿美元,指数正式进入回调区间。但细看板块,分化非常刺眼:真正签 AI 资本开支支票的巨头跌幅有限,Alphabet 跌 2.29%、微软跌 3.25%、亚马逊跌 3.55%;卖铲子的却遭重创,AMD 跌 14.83%、美光跌 14.18%、戴尔跌 12.88%、GE Vernova 跌 11.88%,英伟达跌 7.53%、博通跌 8.07%、Lam 跌 12.44%、应用材料跌 10.31%。

分化有现金流依据。Alphabet 三季度自由现金流为 -91 亿美元,亚马逊过去 12 个月自由现金流为 -424 亿美元,同时指引每年 2200 亿美元资本开支。超大规模厂商有广告与云垄断,可以吸收资本开支放缓或转向;供应商没有这种缓冲,它们的估值却按“吉瓦级数据中心永续复利”定价。

周二的中期选举引入了摩擦。民主党拿下国会,并翻转得州、佐治亚、俄亥俄三个州长席位——这三州正是近期美国新增吉瓦级算力最集中的地方,而候选人公开主张暂停数据中心审批,理由是居民电价飙升。若一个 500MW 的并网许可卡在州公用事业委员会,明年一季度就不需要提货 GPU 与服务器机架。

消费端同时被挤压。高通因手机芯片销售下滑 26% 跌 12.65%,Counterpoint 称全球智能手机出货下降 20%,创 14 年低点。原因之一是美光与 SK 海力士把晶圆产能转向 AI 服务器所需的 HBM,推高普通 DRAM 与 NAND 价格,手机厂商被迫提价;消费者并不愿为“AI 手机”支付溢价,销量于是塌陷。当买家自由现金流为负、地方电网又开始拒绝新增接入,硬件供应商总是最先挨打。

关键事实
  • 纳斯达克单日蒸发约 2.5 万亿美元,进入回调区间
  • AMD -14.83%、美光 -14.18%、戴尔 -12.88%
  • Alphabet 三季度 FCF -91 亿美元;亚马逊 TTM FCF -424 亿美元
  • 全球智能手机出货下降 20%,创 14 年低点
阅读原文 · Tomasz Dziurko / Substack ↗
纳斯达克单日蒸发 2.5 万亿美元:AI 硬件股先于巨头崩了
图注:纳斯达克单日蒸发约 2.5 万亿美元,芯片、内存与电力设备股跌幅远大于超大规模云厂商。图片:Tomasz Dziurko/Substack
The Verge分析市场与地缘约 1 分钟

“彻底否定”:蓝潮将如何冲击 AI 数据中心

‘Total repudiation’: The blue wave is about to hit AI

民主党拿下参众两院,并在多个州承诺暂停数据中心审批;AI 公司公开沉默,私下讨论算力扩张受限,甚至把建设转向海外。

周二,民主党赢下众议院与参议院,蓝潮横扫多个红州与摇摆州:佐治亚选出首位黑人女性州长,新墨西哥选出首位原住民女性州长,缅因一位任职 30 年的参议员败给民主党人。在这些竞选里,一个主题反复出现:让 AI 公司对美国人负责。

直接后果是数据中心政治化。多个新当选的州长承诺暂停数据中心审批或设禁令,理由是居民电价上涨与水资源压力。Meta 平台总裁 Dina Powell McCormick 表示,许多公司正在考虑把数据中心建设移到海外;《华尔街日报》报道,OpenAI 等公司私下讨论了明显的算力容量约束。

行业公开层面几乎集体沉默。OpenAI 与 Anthropic 拒绝向 The Verge 置评;马斯克曾花近 4.5 亿美元支持共和党竞选,选后删除了“投红票”的帖子。即将上任的民主党人承诺把 CEO 们传唤到国会作证。前 X 产品负责人 Nikita Bier 的一条帖子称“这会是 AI 研究者的纽伦堡审判”,在 X 上广泛传播。

对市场的含义是叙事切换:AI 从“算力永远稀缺”变成“许可与电网才是瓶颈”。这也解释了为什么芯片与电力设备供应商先跌,而拥有现金流与云业务的超大规模厂商相对抗跌。政治风险不再是背景变量,而是 AI 资本开支方程里的显式项。

关键事实
  • 民主党赢下众议院与参议院
  • 得州、佐治亚、俄亥俄州长席位翻转
  • 多个州承诺暂停或限制数据中心审批
  • 马斯克投入近 4.5 亿美元,选后删除“投红票”帖
阅读原文 · The Verge ↗
“彻底否定”:蓝潮将如何冲击 AI 数据中心
图注:民主党在中期选举赢下参众两院,多个州长竞选把数据中心审批与电价作为核心议题。图片:Cath Virginia/The Verge
MIT Technology Review市场与地缘约 2 分钟

美国参议院将表决 417 页许可改革法案:清洁能源与天然气一起加速

A new bill could change how the US builds energy infrastructure

BAAJA 法案把联邦能源项目审查压缩,既可能释放 350GW 清洁能源,也可能为数据中心配套的天然气电厂打开闸门。

中期选举刚结束,参议院定于 11 月 9 日表决《两党美国可负担性与就业法案》(BAAJA)。这份 417 页的法案试图压缩联邦能源项目许可流程:缩小需要申请联邦许可的项目范围,设定审查期限,并处理输电规划、采矿等一系列配套问题。

法案的技术中立性造就了奇特联盟。四名参议院提案人两共和党、两民主党;白宫经济顾问委员会称它能缩短审查并提振 GDP;美国清洁能源协会估计可释放 350GW 清洁能源。反对者则担心,缩小环境审查会损害公共土地与社区。

量化结论分歧很大。Rhodium 认为最好情形下,到 2040 年经济整体减排 4%、每户每年省 78 美元、新增 200GW 清洁能源;最差情形排放基本不变。Resources for the Future 估计 2041 年电力部门减排 6%,到本世纪中叶节省超过 3500 亿美元系统成本。但普渡大学 Kevin Kircher 的模型显示,若法案在 2025 年就已实施,能源部门排放会高于实际基线,空气污染相关的健康与死亡风险也会上升。

关键争议是天然气。数据中心推高电力需求,已经有一波天然气电厂项目宣布;许可改革可能同时打开清洁能源与化石能源的闸门。法案能否过关还受政权更替影响:民主党可能等到明年掌控两院再推自己的版本,而任何版本最终都需要特朗普签字。简化审批本身是共识,但“简化后建什么”才是排放与电价的分水岭。

关键事实
  • BAAJA 共 417 页,参议院 11 月 9 日表决
  • 清洁能源协会估计可释放 350GW 清洁能源
  • Rhodium:最好情形 2040 年减排 4%、每户年省 78 美元
  • 数据中心需求可能推动一波新天然气电厂
阅读原文 · MIT Technology Review ↗

思想与评论

Ideas & Commentary 02
Foreign Affairs分析思想与评论约 2 分钟

《外交事务》:中国为何知道问题却不改——一种“否认的经济学”

China’s Economics of Denial

荣鼎集团的 Melton 与 Wright 认为,北京并非信息失真或制度失灵,而是真心相信投资驱动的技术追赶会带来下一轮高增长。

荣鼎集团的 Oliver Melton 与 Logan Wright 提出一个悖论:北京正确诊断了最紧迫的经济问题——投资与出口依赖过重、居民消费疲弱、外部顺差上升、信贷需求不足、失业与隐性失业上升、持续通缩——却只推出温和的促消费措施,整体战略仍是扩大制造业与先进技术投资。

流行解释有三种:习近平没有收到准确信息;安全目标压过发展;政治与制度约束让决策层无法行动。作者认为这些因素都有作用,但更简单的答案是:领导层真心相信这条路有效。中国的经济政策嵌套在长期规划中,短期压力不应干扰长期优先事项;长期战略则押注于控制先进技术与产业会触发新一轮高速增长。

作者把这套思路称为“马克思主义式误用的新古典发展理论”:发展等同于资本积累,生产率被视为技术控制与部署的结果,服务业、工资与消费会在生产型产业成熟后自然跟上。结构失衡因此不是意外,而是“自律”,会以更快的长期增长回报。宏观管理也随之变成政府主动配置资源,而不是用利率与汇率被动调节。

在这种投入产出表式的世界观里,政策目标是让各部门扩大产出、压低价格;某些部门供过于求时,就调整投资节奏与部门平衡。作者的反驳是:当投资与最终需求脱节时,制造业与技术并不会自动提高生产率与工资;中国已是全球最大出口国,无法靠进一步出口吸收产能。结果是更慢的增长、更多贸易摩擦,以及居民收入长期停滞。

关键事实
  • 作者为荣鼎集团 Oliver Melton 与 Logan Wright
  • 北京承认消费疲弱,但政策仍偏向制造业投资
  • 核心概念:“马克思主义式误用的新古典发展理论”
  • 风险:投资与最终需求脱节,出口无法再吸收产能
阅读原文 · Foreign Affairs ↗
《外交事务》:中国为何知道问题却不改——一种“否认的经济学”
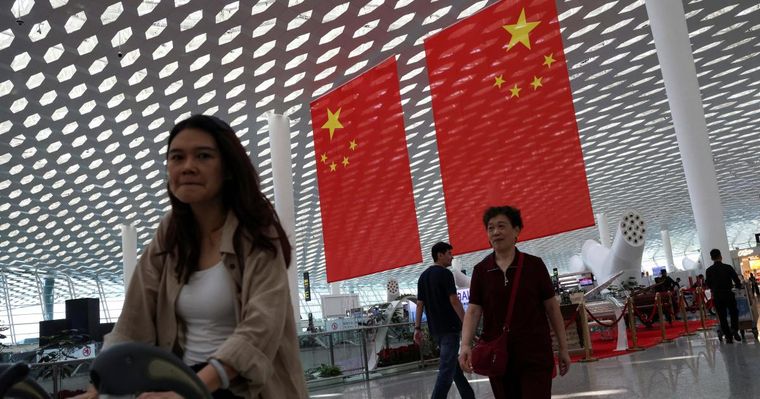
图注:北京一方面承认消费疲弱,另一方面仍把资源导向制造业与先进技术投资。图片:Tingshu Wang/Reuters/Foreign Affairs
War on the Rocks分析思想与评论约 1 分钟

《岩石上的战争》:金穹计划既不可行,也更危险

The Golden Dome Proposal is Destabilizing and Dangerous

两位导弹防御专家指出,金穹即便只是立项,也会促使中俄扩充核弹头与突防手段;助推段拦截把危机决策压缩到数十秒,反而提高核战争风险。

这是关于“金穹”(Golden Dome)两篇系列文章的第二篇。计划目标是建立陆海空天多层防御,保护美国、盟友与前沿部队免受弹道导弹、巡航导弹、高超音速滑翔器、飞机与无人机攻击,并发展在对手导弹发射前将其摧毁的能力。

作者 Frederick Lamb 与 Laura Grego 的核心判断是:对远程弹道导弹,可预见的未来没有建成有效防御的前景;要让系统在纸面上看起来有效,成本也要从数千亿到数万亿美元。更关键的是,即便现有能力有限,只要立项、预算与目标存在,对手就会按“未来可能的能力”作出反应。

反应包括:增加核弹头与导弹数量以饱和防御,部署高超音速滑翔器与部分轨道轰炸系统,发展反卫星与网络武器,强化突防措施。2026 年 2 月新 START 到期后,美俄不再受条约约束,俄罗斯可以迅速在现有导弹上增加弹头,中国也在扩张核武库。军备竞赛因此不是副产品,而是计划本身的结果。

助推段拦截尤其危险:它需要数万颗在轨拦截器,极具挑衅性,并把危机决策时间压缩到数十秒,使危机更快、更自动化、更容易因误判走向核战争。作者结论很明确:核军控协定仍是历史上唯一被证明有效的降低核威胁路径;部署战略导弹防御,哪怕出于最好的意图,也会让美国更不安全。

关键事实
  • 金穹目标:陆海空天多层拦截,含发射前摧毁
  • 有效防御远程弹道导弹在可预见未来不可行
  • 成本从数千亿到数万亿美元
  • 新 START 于 2026 年 2 月到期,军备竞赛风险上升
阅读原文 · War on the Rocks ↗
《岩石上的战争》:金穹计划既不可行,也更危险
图注:文章认为,针对远程弹道导弹的“金穹”防御在可预见未来没有建成有效系统的前景。图片:War on the Rocks
编辑要点
Bottom line

今天的几件事指向同一条线:模型能力还在加速——OpenAI 把网络安全智能体推到“关键”级,百度、腾讯、英伟达继续压低开源与推理成本;但约束已经从芯片转向电力、许可与选票,纳斯达克单日蒸发 2.5 万亿美元正是对这条新瓶颈的定价。更深一层,北京明知消费失衡仍坚持投资驱动,华盛顿明知金穹不可行仍推进,都是“知道代价却选择继续”的政治经济学。