27B 的「判断模型」可以离线跑了:Nace 开源 Drex Max v1
Nace AI Open-Sources Drex Max v1: A 27B Decision Model That Runs Locally on Apple Silicon
导语:Drex Max v1 不生成文本,只对给定上下文和命名问题一次性输出每个选项的概率;27B 稠密权重开放后,agent 路由与工单分诊可以在本地完成。
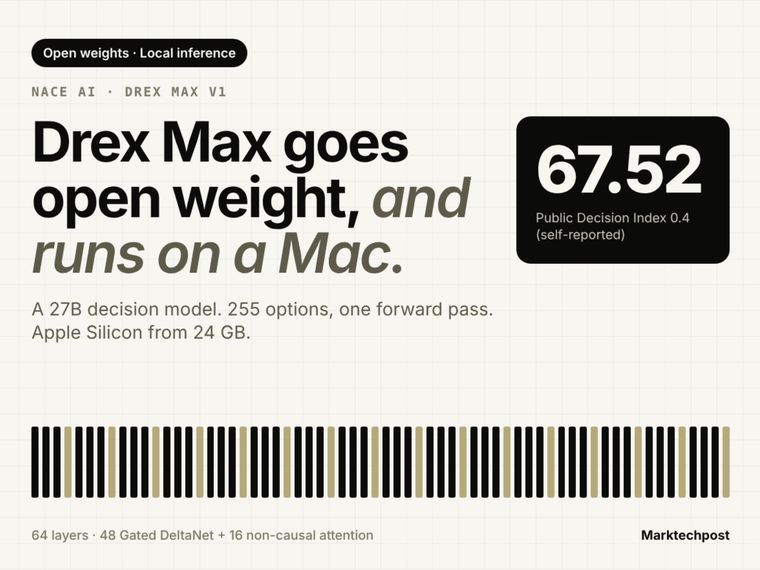
Nace AI 把 Drex Max v1 以开放权重发布。这是一个 27B 稠密模型,提供 bf16 权重、Q8_0 GGUF 和 affine Q4 检查点,并附带 llama.cpp 与 Ollama 的分支。硬件覆盖 H100 bf16、L40S 48GB 八位量化、24GB 以上内存的 Apple Silicon(Q4)或 48GB(Q8),以及纯 CPU。
它不是生成式模型。输入是一段状态(文本、JSON 或图像)加一组命名问题,模型在一次前向传播中给每个选项一个概率,不生成任何 token。问题分三类:在命名选项中做选择、是/否、序数评分;单题最多 255 个选项。这使它适合 agent 路由、工单分诊、策略与护栏检查——这些场景要的是可比较的分数,而不是一段解释。
架构上,64 层里有 48 层是 Gated DeltaNet 线性注意力,从左到右运行;另外 16 层是全注意力,每四层插入一次,且是非因果的,每个 token 都能看到整段序列。图像经原生视觉塔进入,对请求中的每个问题可见;255 路读出头把最后隐状态变成选项概率。配置为 qwen3_5 模型类型,窗口 262,144 token,默认 16,384。
公开的 Decision Index 0.4 得分 67.52,比 Drex v2.0 高 6.27,为自报数据;InfographicVQA 技能分 97.3,工具类任务 81.9。真正值得注意的是形态:把「判断」从云端 API 拆出来,变成可离线、可审计、单次前向的 27B 组件。对本地 agent 栈,这比再做一个聊天模型更有用。
- 27B 稠密,开放 bf16、Q8_0 GGUF、affine Q4 三种权重
- 一次前向输出选项概率,不生成 token;单题最多 255 个选项
- 262,144 token 窗口,默认 16,384;48 层线性注意力 + 16 层全注意力
- Decision Index 0.4 得分 67.52(自报),比 v2.0 高 6.27