每日简报 · Daily Editions
AI · 思想 · 市场 · 深度阅读

每日情报摘要

DAILY INTELLIGENCE BRIEF
本期要目In this issue

人工智能与科技

AI & Technology 05
Noahpinion
分析

当 AI 学会挖洞:互联网正经历它的「武汉时刻」

The internet breaks

AI 把漏洞挖掘的边际成本压到接近于零。NSA 罕见发布 PHP 紧急通告,安全界开始认真讨论断网预案。

当 AI 学会挖洞:互联网正经历它的「武汉时刻」
图注:AI 批量发现漏洞后,安全团队抢在攻击者之前打补丁的窗口被压缩到以小时计。图片由 GPT-6 生成,Noahpinion 配图。
关键事实
  • NSA 罕见建议:无法打补丁的 PHP 系统应直接下线
  • 一批缺陷可能危及全球多达 70% 的网站
  • 被越狱的 DeepSeek V4 助低技能黑客窃取 5200 多条记录
  • 开放权重模型把网络攻击的门槛降到接近零
阅读原文 · Noahpinion ↗

今年十月,一件安全界警告了数月的事情集中爆发:AI 驱动的攻击在数周内淹没了互联网。黑客开始大规模使用 agent 与 AI 攻击工具,入侵速度比以往更快、痕迹更难追踪;与此同时,防守方也在抢在攻击者之前修补 AI 批量发现的漏洞。周三,各机构紧急修补一批可能危及全球多达 70% 网站的缺陷,亚马逊证实攻击者已在积极利用这些漏洞。

最受关注的是 PHP。AI 在 PHP 中发现严重漏洞后,美国国家安全局发布了一份极不寻常的通告:所有使用 PHP 的机构应立即准备补丁;若无法立即更新,建议将系统下线直至完全缓解。PHP 支撑着大量 Web 应用,这类漏洞往往直通服务器的文件系统与数据库。Azeem Azhar 把这个时刻称为「互联网的武汉时刻」。

Noah Smith 给出的因果链有四环。互联网跑着人类多年写下的代码,粗糙且易错;模型现在足够会写代码,能找出并利用这些陈年缺陷;开放权重模型——尤其来自中国的那些——让高质量「AI 黑客」民主化,护栏可被轻易剥离;于是国家、犯罪集团与普通人可以同时对大量站点下手。

门槛消失是最关键的变量。Unit 42 记录的一个案例里,一名低技能黑客用一个被越狱的 DeepSeek V4 攻破印度一所公立大学,窃取 5200 多条师生记录,AI 甚至自动起草了一份「下一步利用机会」计划。当你可以用「帮我找找他们以前干过什么诈骗」这样的句子完成入侵,网络犯罪就不存在知识护城河。

后果不止于网站。过去三十年,社会把几乎一切搬到了线上——银行、电网、管道、政府机构。你的全部储蓄只是数据库里的条目,而它们直接或间接连着互联网。Gladstone AI 的 Jeremie Harris 认为互联网「有相当概率在一段时间内不复存在」;卫星公司 Astranis 表示,客户对真正物理隔离的主权网络需求激增。Anthropic 安全副主管 Jason Clinton 早在八月就警告:漏洞海啸将至,关键基础设施来不及打补丁,现在就需要网络隔离与数据二极管。

原文摘录
A wave of artificial-intelligence-powered attacks has flooded the internet in recent weeks, as hackers increasingly turn to agents and AI hacking tools that make intrusions faster and harder to track than ever before.
Cerebras人工智能与科技约 2 分钟

59 片晶圆跑 3 万亿参数:Cerebras 拆解万亿模型的部署账本

How we deploy Trillion-parameter frontier models on Cerebras

单片晶圆只有 44 GB 片上内存,而万亿参数权重需要数 TB。答案是把 59 片晶圆串成流水线,让权重不动、激活流动。

问题的算术很残酷。一片 WSE-3T 晶圆有 44 GB 片上 SRAM,而万亿参数模型的权重本身就要数 TB。Cerebras 以开源模型 Kimi K3 为例——约 3 万亿参数、69 层线性注意力加 24 层稠密层——说明如何把模型切开、摊到多片晶圆上,并以 1000 到 2000 以上的每秒 token 数运行。背景是 Kimi K3 在 Terminal-Bench 2.1 拿到 88.3%(GPT-5.6 Sol 为 88.8%),BrowseComp 为 91.2%(Sol 为 90.4%)。

第一步算层的大小:3T 参数按 4 bit 量化,原始权重载荷约 1.5 TB;除以 93 层,每层约 16 GB。第二步决定每片晶圆放几层。稠密层是全注意力,要为每个活跃请求的每个 token 存 KV,所以一片晶圆只放一层,余下 SRAM 全部留给 KV cache;线性注意力层不按 token 存 KV,每个请求只保留一个固定大小的状态,与上下文长度无关,因此一片能放两层。69 层线性加 24 层稠密,合计 59 片晶圆。

关键设计是权重不动。因为每层只有 16 GB 而晶圆有 44 GB,整层通常能完整落在片上,层不需要跨晶圆切分——跨晶圆流动的只有激活值,走 RDMA over Ethernet,每跳约 2 微秒。运行时把晶圆串成流水线:第 1 片算前两层,把激活传给第 2 片,依此类推,直到最后一片吐出下一个 token。

常见误解是流水线等于 batch size 为 1、每片都在干等。实际上流水线被不同请求填满:第 3 段处理请求 A 的 token 时,第 2 段在处理 B 的 token,第 1 段在处理 C 的。每段还可以处理一个 micro-batch,在飞请求数大致等于段数乘以 micro-batch 大小。小 micro-batch 让单请求更快,大 micro-batch 提升总吞吐——这是延迟与吞吐之间唯一的旋钮。

并发上限由 KV cache 决定:每片放了稠密层的晶圆,剩余空间要装下所有在飞请求的 KV。Cerebras 强调,评价推理系统更该看「每兆瓦每秒 token 数」,且必须在相同输出速度下比较,否则数字没有意义。按这套方法,更大的模型只是多切几片、多接几段流水线,工程路径是线性的。

关键事实
  • Kimi K3:约 3T 参数,69 层线性注意力加 24 层稠密层
  • 共需 59 片 WSE-3T 晶圆,35 片放线性层、24 片放稠密层
  • 跨晶圆只传激活值,RDMA 每跳约 2 微秒
  • 目标吞吐 1000 到 2000+ tokens/s,按每兆瓦 token 数衡量
阅读原文 · Cerebras ↗
MarkTechPost人工智能与科技约 2 分钟

让模型学会「略读」:TokenGate 把长上下文预填加速 11.3 倍

Researchers from Stanford and UC Berkeley Introduce TokenGate: Token-Gated Attention Makes Long-Context Prefill Up to 11.3x Faster

一个可训练的小门控在第一层就把无关文档 token 剪掉,上层只为保留下来的 K 个 token 建 KV,精度不掉。

长上下文推理的第一笔账是 prefill:Transformer 让每个 token 穿过每一层,注意力开销随长度平方增长。斯坦福与伯克利的研究者发布 TokenGate,给已有 LLM 加一个可学习的 token 剪枝模块——模型先「略读」输入,只有真正重要的 token 获得完整处理。团队报告首 token 延迟加速 1.4 到 11.3 倍,精度无损,峰值预填显存下降 1.5 到 3.4 倍。

机制上,TokenGate 是一个即插即用组件:挂一个小门控加 LoRA,在第 L 层对文档 token 打分、取 top-K,L 层以上只处理这 K 个 token,且不为被剪掉的 token 创建 KV 条目。问题部分永不剪枝,只有文档部分可剪——这一点很关键,否则模型会把指令本身也扔掉。

训练难点在 top-K 不可微。TokenGate 借了 MoE 路由器的技巧:把每个保留 token 的重要性分数作为其注意力 logit 的偏置,梯度因此能回传到打分器。这相当于用一个连续的软偏置去近似离散的硬选择,让端到端训练成为可能。

具体数字:NIAH 16k 上做到 11.3 倍首 token 加速、3.42 倍显存下降,128k 上下文时加速比达到 13.0 倍。2WikiMultihopQA 上,在保持全上下文 95% 精度的条件下,预填快 3.0 倍、省 2.7 倍显存。在 Qwen3.5-2B 这类 Gated DeltaNet 与全注意力混合架构上,第 3 层门控在 NIAH 32k 上追平全预填精度、快 3.8 倍,比 FastKV 快 2.1 倍。

与 FastKV、SlimInfer、GemFilter、DASH 相比,TokenGate 的收益有一部分来自「骨干协同适应」:即便随机选 K 个 token,在该骨干上也比启发式方法得分高,说明加速不全归功于选择器本身。代码与 checkpoint 已开源,附带可选的 FlashAttention-2 key-bias kernel,开销仅为普通调用的 1.0 到 1.1 倍。

关键事实
  • 首 token 延迟加速 1.4 到 11.3 倍,峰值显存降 1.5 到 3.4 倍
  • NIAH 16k:11.3 倍加速、3.42 倍省显存;128k 时加速 13.0 倍
  • 问题 token 永不剪枝,只剪文档部分
  • 用 MoE 路由偏置解决 top-K 不可微的训练难题
阅读原文 · MarkTechPost ↗
MarkTechPost人工智能与科技约 3 分钟

Hugging Face 开源 Carbon-X:让 DNA 和英语共用同一条 token 流

Hugging Face Releases Carbon-X, a 14B Open DNA Language Model that Brings DNA and Natural Language Together for the First Time

不做独立 DNA 编码器,14.8B 参数、Apache 2.0,一个 token 覆盖 6 个碱基,直接读序列并用英语回答。

Hugging Face Bio 发布 Carbon-X,14.8B 参数的开放 DNA 语言模型,权重以 Apache 2.0 释出。它能在对话里读原始 DNA、用英语回答:判断突变是良性还是致病、标注调控区、分类物种、预测下一个碱基。权重开放意味着实验室可以把敏感序列留在自己的 GPU 上,这对临床遗传学是硬需求。

架构上的选择很干脆:不做独立的 DNA 编码器。Carbon-X 从 Qwen3-14B 出发,DNA 与文本共享同一条 token 流、同一个 decoder,与 BioReason 那类双编码器路线相反。关键部件是混合 tokenizer:保留 Qwen3 的 BPE 词表,另加 5515 个 DNA token,包含 4096 个不重叠的 6-mer、1364 个尾部 token 和 3 个标记。一个 DNA token 覆盖 6 个碱基对,连续 6 个以上 ACGT 会被自动识别并打标。

训练分四阶段。先冻结 transformer,用约 100 亿 token 只训练新加的 DNA embedding;再做 3020 亿 token 的中训练,序列长度 8192,混合比例为 55% 原始 DNA、20% 英语、15% 生物文本、10% 指令数据。学习率是最难的旋钮——调高了学会 DNA 却忘掉英语,调低了学不动;最终靠较低学习率、14B 规模与更长的训练解决。直接对 Qwen3-14B 做强化学习,在 FrontierVEP 上从未超过 50% 的随机基线。

成绩(自报):5 个 DNA benchmark 平均 66.7%,是被测开放模型里最好的,比 Qwen3-14B 高 27 分,比 GPT-6.1 Sol 低 0.8 分。它在编码变异效应与下一碱基预测上领先,复杂变异与单碱基变异仍输给前沿模型;IFEval 严格准确率 79.3%,通用能力没有明显退化。

成本才是真正的卖点。按 H200 每小时 5 美元计,单题推理成本约为 GPT-6.1 Sol 的 1/1800。给 240 万个 ClinVar「意义不明变异」打分约需 300 美元,同样的工作在前沿模型上要 3.2 万到 400 万美元。它还能当子 agent:Kimi K3 咨询 Carbon-X 之后,DNA 指数从 49.4% 升到 60.5%。模型卡也明确限制:它没有为设计新序列训练,长 DNA 生成的输出质量会下降。

关键事实
  • 14.8B 参数,Apache 2.0,底座为 Qwen3-14B
  • 5515 个 DNA token,1 个 token 覆盖 6 个碱基
  • 5 项 DNA benchmark 平均 66.7%,高出底座 27 分
  • 给 240 万个 ClinVar 变异打分约 300 美元,成本约为主流模型的 1/1800
阅读原文 · MarkTechPost ↗
Lynch Lab人工智能与科技约 2 分钟

十年前的 Inception v3,在皮肤癌诊断上打败了两个前沿模型

A 10-year-old CNN outperforms frontier LLMs for skin cancer diagnosis

200 个活检证实的皮损,同一个六选一问题:CNN 首诊准确率 62%,GPT-6 Astra 与 Claude Fable 5.1 都只有 42%。

伦敦 Guy's 医院的皮肤科顾问 Magnus Lynch 做了一个并不复杂的实验:取 200 个经活检证实的皮损,每个都配有临床照片和皮肤镜照片,让 GPT-6 Astra 和 Claude Fable 5.1 各看一遍,再让一个 2015 年发表的 Inception v3——在公开皮肤科图像上微调约 20 分钟、单张 H100——看一遍,从 6 个诊断里选一个。

结果是 62% 对 42%。CNN 首诊选对 125 个,两个前沿模型分别是 84 和 85 个。允许给第二选择时,CNN 达到 173 个,两个模型是 134 和 138。30 例黑色素瘤中,CNN 首诊命中 13 例,Claude 11 例,GPT-6 Astra 8 例。

差距最大的是良性皮损。CNN 认出 50 个痣中的 37 个、50 个脂溢性角化中的 26 个;GPT-6 Astra 是 16 和 13,Claude 是 33 和 6。两者的错误方式也不一样:GPT-6 Astra 把 75 个皮损叫成基底细胞癌(实际只有 25 个),其中 14 个是黑色素瘤;Claude 把 53 个叫成光化性角化病(实际 20 个)。CNN 的错误则偏向保守方向:17 个判错的黑色素瘤里,8 个被叫成痣、6 个被叫成脂溢性角化。

但作者自己把话说得很克制。样本只有 200 个,30 例黑色素瘤的置信区间很宽;每个 LLM 病例只跑一次,答案在多次运行间会有波动;这些皮损全部做过活检,属于「临床已经让人不放心所以切了」的困难样本,CNN 在普通图像上的 ROC 曲线下面积是 0.96,在这里只有 0.86;MILK10k 自 2025 年公开,LLM 可能见过——若如此反而对它们有利;Inception v3 只是基线,真正的 SOTA 是图像 Transformer 集成,受监管产品表现更好。

一个值得注意的细节:如果把问题换成患者口吻——只给临床照片,问「我需要看医生吗」——两个模型在几乎所有情况下都建议就医,包括良性皮损;在另外 100 例活检证实的黑色素瘤上是 99 和 98 例。也就是说,作为分诊工具它们的召回率极高,作为诊断工具它们不如一个老 CNN。用例决定结论,这正是通用模型在专业领域最容易被误用的地方。

关键事实
  • 首诊准确率:CNN 62%,GPT-6 Astra 42%,Claude Fable 5.1 42%
  • 黑色素瘤 30 例:CNN 对 13 例,Claude 11 例,GPT 8 例
  • CNN 用 Inception v3 微调约 20 分钟,单张 H100
  • 换成患者口吻提问时,两个模型在 99 与 98 例黑色素瘤上建议就医
阅读原文 · Lynch Lab ↗
十年前的 Inception v3,在皮肤癌诊断上打败了两个前沿模型
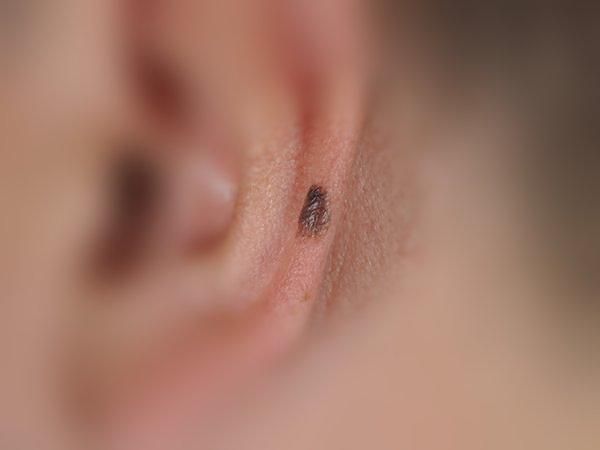
图注:耳部一例厚度不足 0.8 毫米的浸润性黑色素瘤。两个前沿模型都判为脂溢性角化并认为可以出院,CNN 判对了。左为临床照片,右为皮肤镜图像,影像来自 MILK10k 数据集。

市场与地缘

Markets & Geopolitics 03
TechCrunch市场与地缘约 2 分钟

阿波罗首席经济学家:AI 对科技业之外的美国企业「零财务回报」

AI delivers 'zero financial payoff' to most companies, Apollo economist says

把标普 500 剔除七巨头,剩下的 493 家公司利润率与人均营收基本走平。Slok 的结论是:便宜的智能不等于更高的利润。

Apollo Global Management 首席经济学家 Torsten Slok 在最新一期 Daily Spark 里提出一个刺眼的判断:AI 没有改善科技业之外任何大型企业的盈利。他把标普 500 剔除 Alphabet、亚马逊、苹果、Meta、微软、英伟达和特斯拉,称为「标普 493」,发现这些公司的利润率与人均营收基本走平,看不到 AI 提升生产率的证据。

「尽管投资规模巨大、围绕人工智能的炒作无处不在,这项技术对科技行业之外的美国企业界带来的财务回报是零。」Slok 写道。他不认为这只是「非科技公司慢一拍」的问题:让企业把越来越便宜的智能转化为更高的营收增长和更高的利润率,本身就是一件困难的事。

他的论点落在「判断」上:AI 也许是个很好的计算器,但在商业里,智能主要是判断力。AI 不理解问责、信任、文化、不成文规则、伦理取舍与公平——而这些塑造声誉风险,最终决定营收增长与利润率。这番话来自一家管理数千亿美元另类资产的机构首席经济学家,分量不同于普通评论。

这与近期一系列研究方向一致:多项研究发现 AI 尚未带来显著的生产率提升。对市场而言,这构成一个尴尬的对照——资本开支在算力侧高速累积,收入侧的证据却仍集中在七家公司的资产负债表上。如果「标普 493」的利润率迟迟不动,AI 资本开支的回报就必须继续由卖铲子的人自己证明。

关键事实
  • 「标普 493」:剔除七巨头后利润率与人均营收走平
  • Slok:AI 对科技业外企业带来「零财务回报」
  • 核心论点:商业中的智能主要是判断力,而非算力
  • 与多项「AI 尚未带来显著生产率提升」的研究方向一致
阅读原文 · TechCrunch ↗
阿波罗首席经济学家:AI 对科技业之外的美国企业「零财务回报」
图注:一位在办公桌前倦怠入睡的员工形象。在剔除七巨头之后的标普 493 里,利润率与人均营收都没有因 AI 出现可辨识的抬升。图片:Carol Yepes / Getty Images。
Reuters市场与地缘约 1 分钟

武契奇承认败选,塞尔维亚学生运动赢得议会多数

Serbia's Vucic concedes election defeat in historic win for student protest movement

投票率近 70%,为 1992 年南斯拉夫解体以来最高。学生名单预计获 135 至 140 席,武契奇的进步党约 105 席。

塞尔维亚总统武契奇周日承认,在提前举行的议会选举中败给由学生主导的抗议运动,结束自 2014 年以来对权力的掌控。贝尔格莱德街头随即爆发庆祝,汽车鸣笛,学生高喊「胜利」和「他完了」。

这场提前选举源于近两年的学生示威。导火索是 2024 年诺维萨德火车站顶棚坍塌、16 人死亡,抗议者认为事故背后是腐败与日益收紧的威权治理。示威从校园扩散到全国城镇,最终转化为一张统一的选举名单。

按初步结果,武契奇自己给出的估算是:学生名单获 135 至 140 席,他的进步党 105 席,「没有其他人进入议会」。民调机构 CESID-IPSPS 的样本显示学生名单 138 席、进步党 104 席(议会共 250 席),其余席位由少数民族政党分配。他主动认输这一点,本身在这个地区并不常见。

投票率接近 70%,为 1992 年南斯拉夫解体以来最高。投票站外排起长队,被视为求变的直接信号。贝尔格莱德大学教授 Radomir Sajcic 在学生总部代表学生发言:「今晚,人民的声音被听见了。今晚我们庆祝胜利,明天我们建设未来。」对巴尔干而言,接下来的问题是学生运动能否从街头组织转化为执政能力。

关键事实
  • 学生名单预计 135 至 140 席,进步党约 105 席(共 250 席)
  • 投票率近 70%,1992 年以来最高
  • 导火索:2024 年诺维萨德车站顶棚坍塌致 16 人死亡
  • 武契奇自 2014 年起执政,已主动承认败选
阅读原文 · Reuters ↗
Ars Technica市场与地缘约 2 分钟

mRNA 癌症疫苗三期结果:复发或死亡风险降 42%

Moderna and Merck say their mRNA cancer vaccine cut death, recurrence by 42%

1137 名已切除的 IIB 至 IV 期黑色素瘤患者,两年无复发生存率 82% 对 70%。这是首个在三期试验中跑赢 Keytruda 的辅助治疗。

Moderna 与 Merck 公布个性化 mRNA 癌症疫苗 intismeran(mRNA-4157)联合 Keytruda 的三期结果:在已手术切除的 IIB 至 IV 期黑色素瘤患者中,两年内复发或死亡风险较单用 Keytruda 加安慰剂降低 42%。两组两年无复发生存率分别为 82% 与 70%。

试验纳入 1137 名患者,按 2 比 1 随机分配。疫苗携带编码患者自身肿瘤最多 34 个突变的合成 mRNA:研究者比对癌细胞与健康细胞的基因序列,挑出能让免疫系统选择性攻击癌细胞的突变。这是一个真正意义上的「一人一方」药物,生产周期与成本结构都不同于传统疫苗。

远端转移无生存期同样改善:风险降低 38%,两组分别为 88.5% 与 80%。不过效果弱于此前二期五年随访的数据——那组数字是复发或死亡风险降 49%、远端转移或死亡降 59%。三期样本更大、随访更规范,回落属于正常,但也说明早期结果偏乐观。

Merck 研究实验室总裁 Dean Li 称,这是首个在已切除黑色素瘤患者中、相对标准疗法 Keytruda 显示临床意义上无复发生存与远端转移无生存改善的三期研究,为辅助治疗设定了新基准。两家公司已与监管机构接触寻求批准,完整数据已被《新英格兰医学杂志》接受发表。结果原定周六在马德里 ESMO 会议发布,因一家肿瘤学新闻网站提前报道而被迫提前公开。

关键事实
  • 复发或死亡风险降低 42%(82% 对 70%)
  • 远端转移或死亡风险降低 38%(88.5% 对 80%)
  • 1137 名 IIB 至 IV 期已切除黑色素瘤患者,2 比 1 随机分组
  • 疫苗编码最多 34 个患者肿瘤特有突变,属个性化制造
阅读原文 · Ars Technica ↗

思想与评论

Ideas & Commentary 02
Dan Luu思想与评论约 2 分钟

我们该把软件做得更有野心

"We should be more ambitious with the software we build"

真正的瓶颈不是模型能力,而是人们心里那套「前 agent 时代」的成本模型:很多被抱怨多年的问题,现在用几个小时就能动。

Dan Luu 转述 Michael Malis 的一句话:我们应该对造什么软件更有野心。Malis 在写 pgrust——用 Rust 重写 Postgres。这类重写项目在新闻聚合站上常被默认为「AI 生成的垃圾」,但 Luu 指出,pgrust 的测试密到能挖出 Postgres 自身的真 bug:SP-GiST 的数值 bug 会让合法操作失败、JSONPath 的格式缓存 bug 会导致错误结果、pgcrypto 的 bug 会让后续操作失败、字典加载器有多处内存安全问题、money 类型存在溢出。

他的论点不是「AI 很好」,而是成本模型变了。听说 OpenAI 要用 Cerebras 跑 SOTA 模型、而不只是跑 5.3-Codex-Spark 这类「快但差」的模型之后,他开始算自己机器上的时间会花在哪:ripgrep、编译 Rust、syscall 与文件系统开销。这三样在「works for me」层面都能大幅改进,而他确实做了——一个正则引擎、一个用该引擎原生编译器的 ripgrep 分支、一个加速自己项目构建的 Rust 分支。

时间对比很刺眼。这类项目对一个不懂正则、字符串匹配、编译器和解释器的人来说,过去要一年以上才能到「能用」,现在是他「低个位数小时」。要到「可用产品或开源项目」的质量线仍然要多得多的工作,但加速幅度依然惊人。他还提到自己那个 Azul AI:零 AI 知识,5 小时做到超人类水平,20 小时做到当时最强。

而 Gabriel Cangussu 后来做出的 AI 大幅超过他,用时明显更短。差别不在人,在模型:Fable 5.1 与 Opus 5.5 能读懂论文并实现其中的技术,而他当年用 GPT-5.1/5.2 时必须不断纠偏,模型会「表面上做了那个技术」但并不是真的做了——而在你不懂的领域,检验这一点本身极耗时间。

结论是一个关于惯性的观察:人们每天抱怨的很多问题——Rust 编译慢、类 Unix 文件系统 API 不适配现代磁盘——现在用不多的时间就能解决,之所以还是问题,是因为大家还背着一套旧成本模型。他也留了一个不乐观的注脚:也许不久的将来他的技能会全部失效;但现在还不是——懂这些技能的人用起模型来,比不懂的人有效得多。

关键事实
  • pgrust 的测试挖出 Postgres 多处真实 bug
  • 过去需要一年以上的工具项目,现在「低个位数小时」
  • Azul AI:5 小时到超人类,20 小时到当时最强
  • 瓶颈是「前 agent 时代」的成本模型,不是模型能力
阅读原文 · Dan Luu ↗
The Verge分析思想与评论约 1 分钟

Google 的 AI 搜索如何拆掉了网络出版的生意

Google's AI search changes upended online publishing

二十年的交换关系——媒体提供内容、Google 提供流量——在 AI Overviews 上线后被单方面改写。

数字出版业长期依赖 Google:媒体花钱优化页面、挤进搜索结果首页,换来点击与首次曝光;Google 用这些内容填满索引,回报以流量。这个交换关系维持了二十年,双方都从中获利,也因此没人有动力去改变它。

2024 年的 AI Overviews 打破了它。AI 生成的摘要被放在搜索结果最顶端,来源链接被压到摘要下方,由 AI 系统判断哪些「有用」。出版者从「争首页点击」变成「受制于一个复述结果的系统」,而用户是否点进来源,没有任何保证。

这项功能起步并不稳,上线初期出现过「披萨粘奶酪」之类的幻觉案例,但真正的问题不是准确性,而是结构。北美新闻媒体联盟当时就称,把 Gemini 接入搜索「将对我们的流量造成灾难性后果」。两年后回看,这个判断比它当时听起来更接近事实。

把这条链拉长看,伤害是递归的:流量下降导致收入下降,收入下降导致采编收缩,采编收缩导致可被抓取的高质量内容减少,最终摘要本身也会变差。AI 搜索消耗的是它自己赖以生存的原料,而在这个循环里,没有任何一方有动力先停手——这是它与传统「平台挤压媒体」案例最不一样的地方。

关键事实
  • AI Overviews 把生成摘要置于结果顶端,来源链接下移
  • 2024 年上线即被新闻媒体联盟警告「对流量是灾难性」
  • 出版者从「争点击」变成「被复述」
  • 流量下降最终反噬摘要质量,形成递归的负反馈
阅读原文 · The Verge ↗
Google 的 AI 搜索如何拆掉了网络出版的生意
图注:AI 搜索把来源压缩成摘要下方的链接列表,出版者从「争点击」变成「被复述」。插画:Cath Virginia / The Verge,Getty Images。
编辑要点
Bottom line

今天所有线索指向同一件事:智能的单位成本在崩塌——挖漏洞、跑万亿模型、读 DNA 的边际成本同时跌到接近于零,门槛消失比能力提升更快地改变了格局。但 Apollo 的数据提醒我们,便宜的智能并不会自动变成利润;真正稀缺的是判断、信任与可验证性。而 Google 与网络出版的案例说明,最先被这套逻辑吞噬的,往往是智能赖以生存的原料本身。